Más sobre forecasting en: cienciadedatos.net
- Forecasting series temporales con machine learning
- Modelos ARIMA y SARIMAX
- Forecasting series temporales con gradient boosting: XGBoost, LightGBM y CatBoost
- Global Forecasting: Multi-series forecasting
- Forecasting de la demanda eléctrica con machine learning
- Forecasting con deep learning
- Forecasting de visitas a página web con machine learning
- Forecasting del precio de Bitcoin
- Forecasting probabilístico
- Forecasting de demanda intermitente
- Reducir el impacto del Covid en modelos de forecasting
- Modelar series temporales con tendencia utilizando modelos de árboles
Introducción
La predicción de la demanda energética desempeña un papel fundamental en la gestión y planificación de los recursos necesarios para la generación, distribución y utilización de la energía. Predecir la demanda de energía es una tarea compleja en la que influyen factores como los patrones meteorológicos, las condiciones económicas y el comportamiento de la sociedad. Este documento muestra cómo utilizar modelos de machine learning para predecir la demanda de energía.
Series temporales y forecasting
Una serie temporal (time series) es una sucesión de datos ordenados cronológicamente, espaciados a intervalos iguales o desiguales. El proceso de forecasting consiste en predecir el valor futuro de una serie temporal, bien modelando la serie únicamente en función de su comportamiento pasado (autorregresivo) o empleando otras variables externas.
Cuando se trabaja con series temporales, raramente se quiere predecir solo el siguiente elemento de la serie ($t_{+1}$), sino todo un horizonte futuro ($t_{+1}, ..., t_{+n}$) o un punto alejado en el tiempo ($t_{+n}$). Existen varias estrategias que permiten generar este tipo de predicciones. La librería skforecast implementa las siguientes para series temporales univariantes:
- Forecasting multi-step recursivo: dado que para predecir $t_{n}$ se necesita el valor de $t_{n-1}$, y $t_{n-1}$ se desconoce, se aplica un proceso recursivo en el que cada nueva predicción se basa en la anterior. Por ejemplo, para predecir los 5 valores siguientes de una serie temporal, el modelo predice el siguiente valor ($t_{+1}$), y esta predicción se utiliza como entrada para predecir el siguiente ($t_{+2}$), y así sucesivamente. Todo este proceso se automatiza con la clase
ForecasterRecursive.

- Forecasting multi-step directo: este método consiste en entrenar un modelo diferente para cada valor futuro (step) del horizonte de predicción. Por ejemplo, para predecir los 5 siguientes valores de una serie temporal, se entrenan 5 modelos diferentes, uno para cada step. De este modo, las predicciones son independientes entre sí. Todo este proceso se automatiza con la clase
ForecasterDirect.

- Forecasting multi-output: determinados modelos de machine learning, por ejemplo las redes neuronales LSTM (long short-term memory), son capaces de predecir de forma simultánea varios valores de una secuencia (one-shot). Esta estrategia está disponible con la clase
ForecasterRnn.
✏️ Note
Otros dos ejemplos de cómo utilizar machine learning (*gradient boosting*) para forecasting de series temporales son:
Librerías
Las librerías utilizadas en este documento son:
# Tratamiento de datos
# ==============================================================================
import numpy as np
import pandas as pd
from astral.sun import sun
from astral import LocationInfo
from skforecast.datasets import fetch_dataset
# Gráficos
# ==============================================================================
import matplotlib.pyplot as plt
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf
from skforecast.plot import plot_residuals
import plotly.graph_objects as go
import plotly.io as pio
import plotly.offline as poff
pio.templates.default = 'seaborn'
poff.init_notebook_mode(connected=True)
plt.style.use('seaborn-v0_8-darkgrid')
plt.rcParams.update({'font.size': 8})
# Modelado y Forecasting
# ==============================================================================
import skforecast
import lightgbm
import sklearn
from lightgbm import LGBMRegressor
from sklearn.preprocessing import PolynomialFeatures
from sklearn.feature_selection import RFECV
from feature_engine.timeseries.forecasting import WindowFeatures
from skforecast.preprocessing import CalendarFeatures, RollingFeatures
from skforecast.recursive import ForecasterEquivalentDate, ForecasterRecursive
from skforecast.direct import ForecasterDirect
from skforecast.model_selection import (
TimeSeriesFold,
bayesian_search_forecaster,
backtesting_forecaster
)
from skforecast.feature_selection import select_features
from skforecast.stats import calculate_lag_autocorrelation
from skforecast.metrics import calculate_coverage
import shap
# Configuración warnings
# ==============================================================================
import warnings
warnings.filterwarnings('once')
color = '\033[1m\033[38;5;208m'
print(f'{color}Versión skforecast: {skforecast.__version__}')
print(f'{color}Versión scikit-learn: {sklearn.__version__}')
print(f'{color}Versión lightgbm: {lightgbm.__version__}')
print(f'{color}Versión pandas: {pd.__version__}')
print(f'{color}Versión numpy: {np.__version__}')
Versión skforecast: 0.25.0 Versión scikit-learn: 1.7.2 Versión lightgbm: 4.7.0 Versión pandas: 2.3.3 Versión numpy: 2.4.6
Datos
Se dispone de una serie temporal de la demanda de electricidad (MW) para el estado de Victoria (Australia) desde 2012-01-01 hasta 2014-12-31. Los datos empleados en este documento se han obtenido del paquete de R tsibbledata. El set de datos contiene 5 columnas y 52.608 registros completos. La información de cada columna es:
- Time: fecha y hora del registro (almacenada en UTC).
- Date: fecha del registro.
- Demand: demanda de electricidad (MW).
- Temperature: temperatura en Melbourne, capital de Victoria.
- Holiday: indica si el día es festivo.
Nota sobre las unidades y la agregación: el paquete de origen tsibbledata etiqueta Demand como "MWh", pero los valores son en realidad potencia media en MW (demanda operativa media en cada intervalo de 30 minutos). Por eso la serie horaria se construye con la media (mean) y no con la suma (sum): promediar dos lecturas de potencia consecutivas de 30 minutos da la potencia media horaria (MW), que es numéricamente idéntica a la energía horaria (MWh en una ventana de 1 hora). Sumar duplicaría los valores y produciría una serie sin interpretación física válida.
# Descarga de datos
# ==============================================================================
datos = fetch_dataset(name='vic_electricity', raw=True)
datos.info()
╭──────────────────────────── vic_electricity ─────────────────────────────╮ │ Description: │ │ Half-hourly electricity demand for Victoria, Australia │ │ │ │ Source: │ │ O'Hara-Wild M, Hyndman R, Wang E, Godahewa R (2022).tsibbledata: Diverse │ │ Datasets for 'tsibble'. https://tsibbledata.tidyverts.org/, │ │ https://github.com/tidyverts/tsibbledata/. │ │ https://tsibbledata.tidyverts.org/reference/vic_elec.html │ │ │ │ URL: │ │ https://raw.githubusercontent.com/skforecast/skforecast- │ │ datasets/main/data/vic_electricity.csv │ │ │ │ Shape: 52608 rows x 5 columns │ ╰──────────────────────────────────────────────────────────────────────────╯
<class 'pandas.core.frame.DataFrame'> RangeIndex: 52608 entries, 0 to 52607 Data columns (total 5 columns): # Column Non-Null Count Dtype --- ------ -------------- ----- 0 Time 52608 non-null object 1 Demand 52608 non-null float64 2 Temperature 52608 non-null float64 3 Date 52608 non-null object 4 Holiday 52608 non-null bool dtypes: bool(1), float64(2), object(2) memory usage: 1.7+ MB
La columna Time está almacenada como string en UTC (nótese la Z al final de cada valor), mientras que el set de datos original está expresado en la hora local de Melbourne. Para convertirla en datetime, se emplea la función pd.to_datetime() con utc=True. Una vez en formato datetime, y para hacer uso de las funcionalidades de pandas, se establece como índice y se convierte a la zona horaria Australia/Melbourne con tz_convert(). Además, dado que los datos se han registrado cada 30 minutos, se indica la frecuencia '30min'.
# Preparación de los datos
# ==============================================================================
datos['Time'] = pd.to_datetime(datos['Time'], utc=True)
datos = datos.set_index('Time')
datos = datos.tz_convert('Australia/Melbourne')
datos = datos.sort_index()
datos = datos.asfreq('30min')
datos.head(2)
| Demand | Temperature | Date | Holiday | |
|---|---|---|---|---|
| Time | ||||
| 2012-01-01 00:00:00+11:00 | 4382.825174 | 21.40 | 2012-01-01 | True |
| 2012-01-01 00:30:00+11:00 | 4263.365526 | 21.05 | 2012-01-01 | True |
✏️ Note
La demanda eléctrica está determinada por la actividad humana, que sigue el reloj local: el ciclo diario, la diferencia entre días laborables y fines de semana, y los días festivos se definen en hora local. Por este motivo, el índice se convierte de UTC a la zona horaria Australia/Melbourne. Trabajar directamente en UTC desplazaría todos los patrones 10 u 11 horas, por lo que el modelo interpretaría de forma incorrecta la estacionalidad diaria (un pico de mediodía parecería una anomalía de madrugada), y combinar la serie con otra información local, como los días festivos, sería propenso a errores.
Se utiliza un índice con zona horaria (time zone aware), en lugar de eliminar la información de la zona horaria, porque en Victoria se aplica el horario de verano (daylight saving time, DST). En un índice local sin zona horaria, faltaría una hora cada octubre y se duplicaría una hora cada abril, lo que rompería la frecuencia regular que requieren los forecasters. Un índice con zona horaria mantiene una frecuencia regular a lo largo de estas transiciones. El único efecto secundario es que los dos días al año en los que cambia la hora tienen 23 o 25 horas, por lo que, en esos días, el lag 24 no corresponde exactamente a la misma hora local del día anterior. Por la misma razón, dado que las particiones del backtesting tienen una longitud fija de 24 steps, la hora local en la que empieza cada partición se desplaza una hora tras un cambio de horario.
Uno de los primeros análisis que hay que realizar al trabajar con series temporales es verificar que la serie está completa, es decir, que no hay valores ausentes.
# Verificar que un índice temporal está completo
# ==============================================================================
fecha_inicio = datos.index.min()
fecha_fin = datos.index.max()
date_range_completo = pd.date_range(
start=fecha_inicio, end=fecha_fin, freq=datos.index.freq
)
is_index_complete = datos.index.equals(date_range_completo)
print(f'Índice completo: {is_index_complete}')
print(f'Número de filas con valores ausentes: {datos.isnull().any(axis=1).sum()}')
Índice completo: True Número de filas con valores ausentes: 0
# Completar huecos en un índice temporal
# ==============================================================================
# datos.asfreq(freq='30min', fill_value=np.nan)
Aunque los datos se encuentran en intervalos de 30 minutos, el objetivo es crear un modelo capaz de predecir la demanda eléctrica a nivel horario, por lo que se tienen que agregar los datos. Este tipo de transformación es muy sencilla si se combina el índice DatetimeIndex de pandas y su método resample().
Es muy importante utilizar correctamente los argumentos closed='left' y label='right' para no introducir en el entrenamiento información a futuro (leakage)). Supóngase que se dispone de valores para las 10:10, 10:30, 10:45, 11:00, 11:12 y 11:30. Si se quiere obtener el promedio horario, el valor asignado a las 11:00 debe calcularse utilizando los valores de las 10:10, 10:30 y 10:45; y el de las 12:00, con los valores de las 11:00, 11:12 y 11:30.
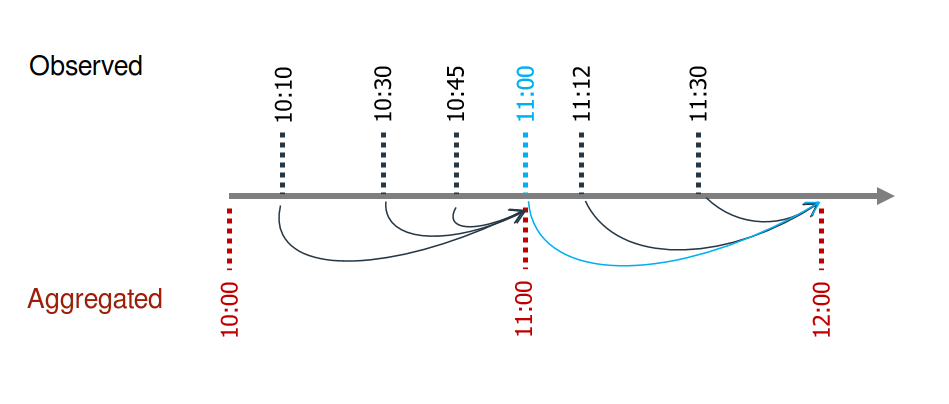
En el promedio de las 11:00 no se incluye el valor puntual de las 11:00 porque, en la realidad, en ese momento exacto todavía no se dispone del valor.
⚠️ Warning
Una agregación incorrecta es una de las formas más fáciles de introducir información del futuro (leakage) en un modelo de forecasting. Las siguientes reglas ayudan a evitarlo:
- Utilizar correctamente el cierre y la etiqueta de los intervalos: cuando se cambia la frecuencia de una serie, cada intervalo debe contener únicamente valores que ya estén disponibles en el instante utilizado para etiquetarlo (
closed='left'ylabel='right'en este ejemplo). - Desplazar las variables calculadas con ventanas móviles: un estadístico móvil utilizado como predictor debe calcularse únicamente con valores pasados. Si la ventana no se desplaza, la variable para el instante t incluye el valor observado en t, que no está disponible cuando se realiza la predicción. La clase
RollingFeaturesde skforecast y la claseWindowFeaturesde feature-engine, ambas utilizadas más adelante en este documento, aplican este desplazamiento automáticamente. - Adaptar la agregación a la naturaleza de la variable: utilizar la media (o el último valor) para variables de estado, como la potencia o la temperatura, y la suma para variables acumulativas, como la energía o las ventas.
# Agregado en intervalos de 1H
# ==============================================================================
# Se elimina la columna Date para que no genere error al agregar.
datos = datos.drop(columns='Date')
datos = (
datos
.resample(rule='h', closed='left', label='right')
.agg({
'Demand': 'mean',
'Temperature': 'mean',
'Holiday': 'mean',
})
)
datos
| Demand | Temperature | Holiday | |
|---|---|---|---|
| Time | |||
| 2012-01-01 01:00:00+11:00 | 4323.095350 | 21.225 | 1.0 |
| 2012-01-01 02:00:00+11:00 | 3963.264688 | 20.625 | 1.0 |
| 2012-01-01 03:00:00+11:00 | 3950.913495 | 20.325 | 1.0 |
| 2012-01-01 04:00:00+11:00 | 3627.860675 | 19.850 | 1.0 |
| 2012-01-01 05:00:00+11:00 | 3396.251676 | 19.025 | 1.0 |
| ... | ... | ... | ... |
| 2014-12-31 20:00:00+11:00 | 4069.625550 | 21.600 | 0.0 |
| 2014-12-31 21:00:00+11:00 | 3909.230704 | 20.300 | 0.0 |
| 2014-12-31 22:00:00+11:00 | 3900.600901 | 19.650 | 0.0 |
| 2014-12-31 23:00:00+11:00 | 3758.236494 | 18.100 | 0.0 |
| 2015-01-01 00:00:00+11:00 | 3785.650720 | 17.200 | 0.0 |
26304 rows × 3 columns
Tras la agregación, el set de datos empieza el 2012-01-01 01:00:00 y termina el 2015-01-01 00:00:00 (cada marca temporal etiqueta la hora que finaliza en ese instante). Se descarta el último registro para que la serie termine el 2014-12-31 23:00:00. Además, para poder optimizar los hiperparámetros del modelo y evaluar su capacidad predictiva, se dividen los datos en 3 conjuntos: entrenamiento, validación y test.
# Separación datos train-val-test
# ==============================================================================
datos = datos.loc[:'2014-12-31 23:00:00', :].copy()
fin_train = '2013-12-31 23:59:00'
fin_validacion = '2014-09-30 23:59:00'
datos_train = datos.loc[: fin_train, :].copy()
datos_val = datos.loc[fin_train:fin_validacion, :].copy()
datos_test = datos.loc[fin_validacion:, :].copy()
print(
f'Fechas train : {datos_train.index.min()} --- {datos_train.index.max()} '
f'(n={len(datos_train)})'
)
print(
f'Fechas validación : {datos_val.index.min()} --- {datos_val.index.max()} '
f'(n={len(datos_val)})'
)
print(
f'Fechas test : {datos_test.index.min()} --- {datos_test.index.max()} '
f'(n={len(datos_test)})'
)
Fechas train : 2012-01-01 01:00:00+11:00 --- 2013-12-31 23:00:00+11:00 (n=17543) Fechas validación : 2014-01-01 00:00:00+11:00 --- 2014-09-30 23:00:00+10:00 (n=6553) Fechas test : 2014-10-01 00:00:00+10:00 --- 2014-12-31 23:00:00+11:00 (n=2207)
Exploración gráfica
La exploración gráfica de series temporales es una forma eficaz de identificar tendencias, patrones y estacionalidad. Esto, a su vez, ayuda a orientar la selección del modelo de forecasting más adecuado.
Gráfico de la serie temporal
Serie temporal completa
# Gráfico interactivo de la serie temporal
# ==============================================================================
fig = go.Figure()
for partition, name in zip(
[datos_train, datos_val, datos_test], ['Train', 'Validation', 'Test']
):
fig.add_trace(
go.Scatter(x=partition.index, y=partition['Demand'], mode='lines', name=name)
)
fig.update_layout(
title='Demanda eléctrica horaria',
xaxis_title='Fecha',
yaxis_title='Demanda (MW)',
legend_title='Partición:',
width=800,
height=400,
margin=dict(l=20, r=20, t=35, b=20),
legend=dict(orientation='h', yanchor='top', y=1, xanchor='left', x=0.001)
)
# fig.update_xaxes(rangeslider_visible=True)
fig.show()
El gráfico anterior muestra que la demanda eléctrica tiene estacionalidad anual. Se observa un incremento centrado en el mes de julio y picos de demanda muy acentuados entre enero y marzo. Dado que Victoria se encuentra en el hemisferio sur, el incremento de julio corresponde al invierno (calefacción), mientras que los picos entre enero y marzo se deben a las olas de calor del verano (aire acondicionado).
Sección de la serie temporal
Debido a la varianza de la serie temporal, no es posible apreciar el patrón intradiario en un gráfico de la serie completa.
# Gráfico serie temporal con zoom
# ==============================================================================
zoom = ('2013-05-01 14:00:00','2013-06-01 14:00:00')
fig, axs = plt.subplots(2, 1, figsize=(8, 4), gridspec_kw={'height_ratios': [1, 2]})
datos['Demand'].plot(ax=axs[0], color='black', alpha=0.5)
axs[0].axvspan(zoom[0], zoom[1], color='blue', alpha=0.7)
axs[0].set_title('Demanda eléctrica')
axs[0].set_xlabel('')
datos.loc[zoom[0] : zoom[1], 'Demand'].plot(ax=axs[1], color='blue')
axs[1].set_title(f'Zoom: {zoom[0]} a {zoom[1]}', fontsize=10)
plt.tight_layout()
plt.show()

Al aplicar zoom sobre la serie temporal, se hace patente una clara estacionalidad semanal, con consumos más elevados durante la semana laboral (lunes a viernes) y menores en los fines de semana. Se observa también que existe una clara correlación entre el consumo de un día y el del día anterior.
Gráficos de estacionalidad
Los gráficos de estacionalidad son una herramienta útil para identificar patrones estacionales en una serie temporal. Se crean agrupando los valores de la serie por cada periodo estacional (mes, día de la semana, hora del día) y representando su distribución o su promedio.
# Estacionalidad anual, semanal y diaria
# ==============================================================================
fig, axs = plt.subplots(2, 2, figsize=(8, 5), sharex=False, sharey=True)
axs = axs.ravel()
flierprops = {'markersize': 3, 'alpha': 0.3}
# Distribución de demanda por mes
datos['month'] = datos.index.month
datos.boxplot(column='Demand', by='month', ax=axs[0], flierprops=flierprops)
datos.groupby('month')['Demand'].median().plot(style='o-', linewidth=0.8, ax=axs[0])
axs[0].set_ylabel('Demand')
axs[0].set_title('Distribución de demanda por mes', fontsize=9)
# Distribución de demanda por día de la semana (1 = lunes)
datos['week_day'] = datos.index.day_of_week + 1
datos.boxplot(column='Demand', by='week_day', ax=axs[1], flierprops=flierprops)
datos.groupby('week_day')['Demand'].median().plot(style='o-', linewidth=0.8, ax=axs[1])
axs[1].set_ylabel('Demand')
axs[1].set_title('Distribución de demanda por día de la semana', fontsize=9)
# Distribución de demanda por hora del día (0 a 23, hora local)
datos['hour_day'] = datos.index.hour
datos.boxplot(column='Demand', by='hour_day', ax=axs[2], flierprops=flierprops)
# Las cajas se dibujan en las posiciones 1 a 24, por lo que las medianas se
# representan en esas mismas posiciones
median_hour = datos.groupby('hour_day')['Demand'].median()
axs[2].plot(range(1, 25), median_hour.to_numpy(), 'o-', linewidth=0.8)
axs[2].set_ylabel('Demand')
axs[2].set_title('Distribución de demanda por hora del día', fontsize=9)
# Distribución de demanda por día de la semana y hora del día
mean_day_hour = datos.groupby(['week_day', 'hour_day'])['Demand'].mean()
mean_day_hour.plot(ax=axs[3])
axs[3].set(
title = 'Promedio de demanda durante la semana',
xticks = [i * 24 for i in range(7)],
xticklabels = ['Lun', 'Mar', 'Mié', 'Jue', 'Vie', 'Sáb', 'Dom'],
xlabel = 'Día y hora',
ylabel = 'Demanda promedio'
)
axs[3].title.set_size(10)
fig.suptitle('Gráficos de estacionalidad', fontsize=12)
fig.tight_layout()

A partir de los gráficos, se observa que la red eléctrica presenta un patrón cíclico y muy predecible, típico de una región del hemisferio sur con comportamientos estacionales y residenciales bien diferenciados.
Comportamiento anual y estacional
La calefacción en invierno domina la demanda base: los meses de junio, julio y agosto (meses 6 a 8) muestran la mediana de consumo más alta. Esto indica un uso intenso y sostenido de la calefacción durante el invierno australiano.
La refrigeración en verano genera picos extremos: enero y febrero (meses 1 y 2) presentan una mediana de demanda inferior, pero con valores atípicos muy elevados. Esto pone de manifiesto que, aunque el consumo base en verano es menor, las olas de calor extremo provocan un uso intenso y simultáneo del aire acondicionado en toda la red.
Las estaciones intermedias son estables: la primavera (septiembre a noviembre) y el otoño (marzo a mayo) muestran la menor demanda global y la distribución más estrecha, ya que son periodos en los que no se requiere un uso intenso ni de la calefacción ni de la refrigeración.
Patrones de actividad semanal
Fuerte influencia de la actividad comercial: los días 1 a 5 (lunes a viernes) mantienen un consumo elevado y constante, reflejo del horario habitual de la actividad industrial y comercial.
Reducción de la carga en fin de semana: los días 6 y 7 (sábado y domingo) muestran una caída notable de la demanda base. La ausencia de actividad comercial explica esta reducción, aunque ocasionalmente siguen apareciendo valores atípicos de alta demanda.
Ciclos intradiarios
Valle nocturno: el menor consumo se produce de forma sistemática entre las 03:00 y las 05:00, cuando la población duerme y la actividad comercial está detenida.
Pico de la tarde: el momento de mayor exigencia diaria para la red se produce entre las 18:00 y las 20:00. Corresponde al momento en que las personas vuelven a casa del trabajo, encienden la climatización, cocinan y utilizan los electrodomésticos.
Rampa de la mañana: un segundo pico, de menor magnitud, aparece entre las 08:00 y las 09:00, cuando abren los negocios y se activan los hogares. Es claramente visible en el gráfico del promedio semanal.
Gráficos de autocorrelación
Los gráficos de autocorrelación muestran la correlación entre una serie temporal y sus valores pasados. Son una herramienta útil para identificar el orden de un modelo autorregresivo, es decir, los valores pasados (lags) que se deben incluir en el modelo.
La función de autocorrelación (ACF) mide la correlación entre una serie temporal y sus valores pasados. La función de autocorrelación parcial (PACF) mide la correlación entre una serie temporal y sus valores pasados, pero solo después de eliminar las variaciones explicadas por los valores pasados intermedios.
# Gráfico autocorrelación
# ==============================================================================
fig, ax = plt.subplots(figsize=(5, 2))
plot_acf(datos['Demand'], ax=ax, lags=60, fft=True)
plt.show()

# Gráfico autocorrelación parcial
# ==============================================================================
fig, ax = plt.subplots(figsize=(5, 2))
plot_pacf(datos['Demand'], ax=ax, lags=60, method='burg')
plt.show()

# Top 10 lags con mayor autocorrelación parcial absoluta
# ==============================================================================
calculate_lag_autocorrelation(
data = datos['Demand'],
n_lags = 60,
sort_by = 'partial_autocorrelation_abs'
).head(10)
| lag | partial_autocorrelation_abs | partial_autocorrelation | autocorrelation_abs | autocorrelation | |
|---|---|---|---|---|---|
| 0 | 1 | 0.949499 | 0.949499 | 0.949499 | 0.949499 |
| 1 | 25 | 0.758061 | -0.758061 | 0.731629 | 0.731629 |
| 2 | 2 | 0.657359 | -0.657359 | 0.836831 | 0.836831 |
| 3 | 26 | 0.623298 | 0.623298 | 0.622439 | 0.622439 |
| 4 | 24 | 0.307323 | -0.307323 | 0.785673 | 0.785673 |
| 5 | 19 | 0.290091 | 0.290091 | 0.302533 | 0.302533 |
| 6 | 21 | 0.268431 | 0.268431 | 0.537376 | 0.537376 |
| 7 | 27 | 0.257939 | -0.257939 | 0.488291 | 0.488291 |
| 8 | 20 | 0.200966 | 0.200966 | 0.414932 | 0.414932 |
| 9 | 9 | 0.184286 | 0.184286 | 0.037667 | 0.037667 |
Los gráficos de autocorrelación muestran una clara asociación entre la demanda de una hora y las horas anteriores, así como entre la demanda de una hora y la demanda de esa misma hora en los días anteriores. La tabla de autocorrelación parcial muestra que los lags más informativos son los más recientes (1 y 2) y los situados en torno a un día antes (24, 25 y 26). Este tipo de correlación es un indicativo de que los modelos autorregresivos pueden funcionar bien.
Modelo baseline
Al enfrentarse a un problema de forecasting, es recomendable disponer de un modelo de referencia (baseline). Suele tratarse de un modelo muy sencillo que puede utilizarse como referencia para evaluar si merece la pena aplicar modelos más complejos.
Skforecast permite crear fácilmente un modelo de referencia con su clase ForecasterEquivalentDate (véase la guía de usuario sobre forecasters baseline). Este modelo, también conocido como Seasonal Naive Forecasting, simplemente devuelve el valor observado en el mismo periodo de la temporada anterior (por ejemplo, el mismo día laboral de la semana anterior, la misma hora del día anterior, etc.).
A partir del análisis exploratorio realizado, el modelo de referencia será el que prediga cada hora utilizando el valor de la misma hora del día anterior.
✏️ Note
En las siguientes celdas de código, se entrena un modelo baseline y se evalúa su capacidad predictiva mediante un proceso de backtesting. Si este concepto es nuevo para ti, no te preocupes: se explicará en detalle a lo largo del documento. Por ahora, basta con saber que el proceso de backtesting consiste en entrenar el modelo con una cierta cantidad de datos y evaluar su capacidad predictiva con los datos que el modelo no ha visto. La métrica de error se utilizará como referencia para comparar la capacidad predictiva de los modelos más complejos que se implementarán a lo largo del documento.
# Crear un baseline: valor de la misma hora del día anterior
# ==============================================================================
# El offset se expresa como número de steps (24 horas). Con un índice con zona
# horaria, un offset de calendario como pd.DateOffset(days=1) falla en los
# cambios de horario de verano porque algunas horas locales no existen.
forecaster = ForecasterEquivalentDate(
offset = 24,
n_offsets = 1
)
# Entrenamiento del forecaster
# ==============================================================================
forecaster.fit(y=datos.loc[:fin_validacion, 'Demand'])
forecaster
ForecasterEquivalentDate
General Information
- Estimator: NoneType
- Offset: 24
- Number of offsets: 1
- Aggregation function: mean
- Window size: 24
- Creation date: 2026-09-22 09:18:22
- Last fit date: 2026-09-22 09:18:22
- Skforecast version: 0.25.0
- Python version: 3.13.14
- Forecaster id: None
Training Information
- Training range: [Timestamp('2012-01-01 01:00:00+1100', tz='Australia/Melbourne'), Timestamp('2014-09-30 23:00:00+1000', tz='Australia/Melbourne')]
- Training index type: DatetimeIndex
- Training index frequency: h
# Backtesting
# ==============================================================================
cv = TimeSeriesFold(
steps = 24,
initial_train_size = len(datos.loc[:fin_validacion]),
refit = False
)
metrica, predicciones = backtesting_forecaster(
forecaster = forecaster,
y = datos['Demand'],
cv = cv,
metric = 'mean_absolute_error'
)
metrica_baseline = metrica
metrica_baseline
| mean_absolute_error | |
|---|---|
| 0 | 318.694833 |
El error del modelo baseline se utiliza como referencia para evaluar si merece la pena aplicar modelos más complejos.
Forecasting multi-step recursivo
Se entrena un modelo autorregresivo recursivo ForecasterRecursive con un modelo gradient boosting LGBMRegressor como estimador para predecir la demanda de energía de las próximas 24 horas.
Se utilizan como predictores los valores de demanda de las últimas 24 horas (lags 1 a 24) y la media móvil de los últimos 3 días (72 horas), creada con la clase RollingFeatures. Los hiperparámetros del estimador se dejan en sus valores por defecto.
# Crear el forecaster
# ==============================================================================
# Lags: demanda de las últimas 24 horas
lags = 24
window_features = RollingFeatures(stats=['mean'], window_sizes=24 * 3)
forecaster = ForecasterRecursive(
estimator = LGBMRegressor(random_state=15926, verbose=-1),
lags = lags,
window_features = window_features
)
# Entrenamiento del forecaster
# ==============================================================================
forecaster.fit(y=datos.loc[:fin_validacion, 'Demand'])
forecaster
ForecasterRecursive
General Information
- Estimator: LGBMRegressor
- Lags: [ 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24]
- Window features: ['roll_mean_72']
- Calendar features: None
- Window size: 72
- Series name: Demand
- Exogenous included: False
- Categorical features: auto
- Weight function included: False
- Differentiation order: None
- Drop NaN from series: False
- Creation date: 2026-09-22 09:18:23
- Last fit date: 2026-09-22 09:18:28
- Skforecast version: 0.25.0
- Python version: 3.13.14
- Forecaster id: None
Exogenous Variables
None
Data Transformations
- Transformer for y: None
- Transformer for exog: None
Training Information
- Training range: [Timestamp('2012-01-01 01:00:00+1100', tz='Australia/Melbourne'), Timestamp('2014-09-30 23:00:00+1000', tz='Australia/Melbourne')]
- Training index type: DatetimeIndex
- Training index frequency: h
Estimator Parameters
-
{'boosting_type': 'gbdt', 'class_weight': None, 'colsample_bytree': 1.0, 'importance_type': 'split', 'learning_rate': 0.1, 'max_depth': -1, 'min_child_samples': 20, 'min_child_weight': 0.001, 'min_split_gain': 0.0, 'n_estimators': 100, 'n_jobs': None, 'num_leaves': 31, 'objective': None, 'random_state': 15926, 'reg_alpha': 0.0, 'reg_lambda': 0.0, 'subsample': 1.0, 'subsample_for_bin': 200000, 'subsample_freq': 0, 'verbose': -1}
Fit Kwargs
-
{}
Backtesting
Para obtener una estimación robusta de la capacidad predictiva del modelo, se realiza un proceso de backtesting. El proceso de backtesting consiste en generar una predicción para cada observación del conjunto de test, siguiendo el mismo procedimiento que se seguiría si el modelo estuviese en producción, y finalmente comparar el valor predicho con el valor real.
El proceso de backtesting se aplica mediante la función backtesting_forecaster(). Para este caso de uso, la simulación se lleva a cabo de la siguiente manera: el modelo se entrena con datos de 2012-01-01 01:00 a 2014-09-30 23:00, y luego predice las siguientes 24 horas cada día a las 23:59. La métrica de error utilizada es el error absoluto medio (MAE).
Se recomienda revisar la documentación de la función backtesting_forecaster() para comprender mejor sus capacidades. Esto ayudará a utilizar todo su potencial para analizar la capacidad predictiva del modelo.
# Backtesting
# ==============================================================================
metrica, predicciones = backtesting_forecaster(
forecaster = forecaster,
y = datos['Demand'],
cv = cv,
metric = 'mean_absolute_error',
verbose = True, # False para no mostrar información
)
metrica_recursive_no_exog = metrica
Information of folds
--------------------
Number of observations used for initial training: 24096
Number of observations used for backtesting: 2207
Number of folds: 92
Number skipped folds: 0
Number of steps per fold: 24
Number of steps to exclude between last observed data (last window) and predictions (gap): 0
Last fold only includes 23 observations.
Fold: 0
Training: 2012-01-01 01:00:00+11:00 -- 2014-09-30 23:00:00+10:00 (n=24096)
Validation: 2014-10-01 00:00:00+10:00 -- 2014-10-01 23:00:00+10:00 (n=24)
Fold: 1
Training: No training in this fold
Validation: 2014-10-02 00:00:00+10:00 -- 2014-10-02 23:00:00+10:00 (n=24)
Fold: 2
Training: No training in this fold
Validation: 2014-10-03 00:00:00+10:00 -- 2014-10-03 23:00:00+10:00 (n=24)
Fold: 3
Training: No training in this fold
Validation: 2014-10-04 00:00:00+10:00 -- 2014-10-04 23:00:00+10:00 (n=24)
Fold: 4
Training: No training in this fold
Validation: 2014-10-05 00:00:00+10:00 -- 2014-10-06 00:00:00+11:00 (n=24)
Fold: 5
Training: No training in this fold
Validation: 2014-10-06 01:00:00+11:00 -- 2014-10-07 00:00:00+11:00 (n=24)
Fold: 6
Training: No training in this fold
Validation: 2014-10-07 01:00:00+11:00 -- 2014-10-08 00:00:00+11:00 (n=24)
Fold: 7
Training: No training in this fold
Validation: 2014-10-08 01:00:00+11:00 -- 2014-10-09 00:00:00+11:00 (n=24)
Fold: 8
Training: No training in this fold
Validation: 2014-10-09 01:00:00+11:00 -- 2014-10-10 00:00:00+11:00 (n=24)
Fold: 9
Training: No training in this fold
Validation: 2014-10-10 01:00:00+11:00 -- 2014-10-11 00:00:00+11:00 (n=24)
Fold: 10
Training: No training in this fold
Validation: 2014-10-11 01:00:00+11:00 -- 2014-10-12 00:00:00+11:00 (n=24)
Fold: 11
Training: No training in this fold
Validation: 2014-10-12 01:00:00+11:00 -- 2014-10-13 00:00:00+11:00 (n=24)
Fold: 12
Training: No training in this fold
Validation: 2014-10-13 01:00:00+11:00 -- 2014-10-14 00:00:00+11:00 (n=24)
Fold: 13
Training: No training in this fold
Validation: 2014-10-14 01:00:00+11:00 -- 2014-10-15 00:00:00+11:00 (n=24)
Fold: 14
Training: No training in this fold
Validation: 2014-10-15 01:00:00+11:00 -- 2014-10-16 00:00:00+11:00 (n=24)
Fold: 15
Training: No training in this fold
Validation: 2014-10-16 01:00:00+11:00 -- 2014-10-17 00:00:00+11:00 (n=24)
Fold: 16
Training: No training in this fold
Validation: 2014-10-17 01:00:00+11:00 -- 2014-10-18 00:00:00+11:00 (n=24)
Fold: 17
Training: No training in this fold
Validation: 2014-10-18 01:00:00+11:00 -- 2014-10-19 00:00:00+11:00 (n=24)
Fold: 18
Training: No training in this fold
Validation: 2014-10-19 01:00:00+11:00 -- 2014-10-20 00:00:00+11:00 (n=24)
Fold: 19
Training: No training in this fold
Validation: 2014-10-20 01:00:00+11:00 -- 2014-10-21 00:00:00+11:00 (n=24)
Fold: 20
Training: No training in this fold
Validation: 2014-10-21 01:00:00+11:00 -- 2014-10-22 00:00:00+11:00 (n=24)
Fold: 21
Training: No training in this fold
Validation: 2014-10-22 01:00:00+11:00 -- 2014-10-23 00:00:00+11:00 (n=24)
Fold: 22
Training: No training in this fold
Validation: 2014-10-23 01:00:00+11:00 -- 2014-10-24 00:00:00+11:00 (n=24)
Fold: 23
Training: No training in this fold
Validation: 2014-10-24 01:00:00+11:00 -- 2014-10-25 00:00:00+11:00 (n=24)
Fold: 24
Training: No training in this fold
Validation: 2014-10-25 01:00:00+11:00 -- 2014-10-26 00:00:00+11:00 (n=24)
Fold: 25
Training: No training in this fold
Validation: 2014-10-26 01:00:00+11:00 -- 2014-10-27 00:00:00+11:00 (n=24)
Fold: 26
Training: No training in this fold
Validation: 2014-10-27 01:00:00+11:00 -- 2014-10-28 00:00:00+11:00 (n=24)
Fold: 27
Training: No training in this fold
Validation: 2014-10-28 01:00:00+11:00 -- 2014-10-29 00:00:00+11:00 (n=24)
Fold: 28
Training: No training in this fold
Validation: 2014-10-29 01:00:00+11:00 -- 2014-10-30 00:00:00+11:00 (n=24)
Fold: 29
Training: No training in this fold
Validation: 2014-10-30 01:00:00+11:00 -- 2014-10-31 00:00:00+11:00 (n=24)
Fold: 30
Training: No training in this fold
Validation: 2014-10-31 01:00:00+11:00 -- 2014-11-01 00:00:00+11:00 (n=24)
Fold: 31
Training: No training in this fold
Validation: 2014-11-01 01:00:00+11:00 -- 2014-11-02 00:00:00+11:00 (n=24)
Fold: 32
Training: No training in this fold
Validation: 2014-11-02 01:00:00+11:00 -- 2014-11-03 00:00:00+11:00 (n=24)
Fold: 33
Training: No training in this fold
Validation: 2014-11-03 01:00:00+11:00 -- 2014-11-04 00:00:00+11:00 (n=24)
Fold: 34
Training: No training in this fold
Validation: 2014-11-04 01:00:00+11:00 -- 2014-11-05 00:00:00+11:00 (n=24)
Fold: 35
Training: No training in this fold
Validation: 2014-11-05 01:00:00+11:00 -- 2014-11-06 00:00:00+11:00 (n=24)
Fold: 36
Training: No training in this fold
Validation: 2014-11-06 01:00:00+11:00 -- 2014-11-07 00:00:00+11:00 (n=24)
Fold: 37
Training: No training in this fold
Validation: 2014-11-07 01:00:00+11:00 -- 2014-11-08 00:00:00+11:00 (n=24)
Fold: 38
Training: No training in this fold
Validation: 2014-11-08 01:00:00+11:00 -- 2014-11-09 00:00:00+11:00 (n=24)
Fold: 39
Training: No training in this fold
Validation: 2014-11-09 01:00:00+11:00 -- 2014-11-10 00:00:00+11:00 (n=24)
Fold: 40
Training: No training in this fold
Validation: 2014-11-10 01:00:00+11:00 -- 2014-11-11 00:00:00+11:00 (n=24)
Fold: 41
Training: No training in this fold
Validation: 2014-11-11 01:00:00+11:00 -- 2014-11-12 00:00:00+11:00 (n=24)
Fold: 42
Training: No training in this fold
Validation: 2014-11-12 01:00:00+11:00 -- 2014-11-13 00:00:00+11:00 (n=24)
Fold: 43
Training: No training in this fold
Validation: 2014-11-13 01:00:00+11:00 -- 2014-11-14 00:00:00+11:00 (n=24)
Fold: 44
Training: No training in this fold
Validation: 2014-11-14 01:00:00+11:00 -- 2014-11-15 00:00:00+11:00 (n=24)
Fold: 45
Training: No training in this fold
Validation: 2014-11-15 01:00:00+11:00 -- 2014-11-16 00:00:00+11:00 (n=24)
Fold: 46
Training: No training in this fold
Validation: 2014-11-16 01:00:00+11:00 -- 2014-11-17 00:00:00+11:00 (n=24)
Fold: 47
Training: No training in this fold
Validation: 2014-11-17 01:00:00+11:00 -- 2014-11-18 00:00:00+11:00 (n=24)
Fold: 48
Training: No training in this fold
Validation: 2014-11-18 01:00:00+11:00 -- 2014-11-19 00:00:00+11:00 (n=24)
Fold: 49
Training: No training in this fold
Validation: 2014-11-19 01:00:00+11:00 -- 2014-11-20 00:00:00+11:00 (n=24)
Fold: 50
Training: No training in this fold
Validation: 2014-11-20 01:00:00+11:00 -- 2014-11-21 00:00:00+11:00 (n=24)
Fold: 51
Training: No training in this fold
Validation: 2014-11-21 01:00:00+11:00 -- 2014-11-22 00:00:00+11:00 (n=24)
Fold: 52
Training: No training in this fold
Validation: 2014-11-22 01:00:00+11:00 -- 2014-11-23 00:00:00+11:00 (n=24)
Fold: 53
Training: No training in this fold
Validation: 2014-11-23 01:00:00+11:00 -- 2014-11-24 00:00:00+11:00 (n=24)
Fold: 54
Training: No training in this fold
Validation: 2014-11-24 01:00:00+11:00 -- 2014-11-25 00:00:00+11:00 (n=24)
Fold: 55
Training: No training in this fold
Validation: 2014-11-25 01:00:00+11:00 -- 2014-11-26 00:00:00+11:00 (n=24)
Fold: 56
Training: No training in this fold
Validation: 2014-11-26 01:00:00+11:00 -- 2014-11-27 00:00:00+11:00 (n=24)
Fold: 57
Training: No training in this fold
Validation: 2014-11-27 01:00:00+11:00 -- 2014-11-28 00:00:00+11:00 (n=24)
Fold: 58
Training: No training in this fold
Validation: 2014-11-28 01:00:00+11:00 -- 2014-11-29 00:00:00+11:00 (n=24)
Fold: 59
Training: No training in this fold
Validation: 2014-11-29 01:00:00+11:00 -- 2014-11-30 00:00:00+11:00 (n=24)
Fold: 60
Training: No training in this fold
Validation: 2014-11-30 01:00:00+11:00 -- 2014-12-01 00:00:00+11:00 (n=24)
Fold: 61
Training: No training in this fold
Validation: 2014-12-01 01:00:00+11:00 -- 2014-12-02 00:00:00+11:00 (n=24)
Fold: 62
Training: No training in this fold
Validation: 2014-12-02 01:00:00+11:00 -- 2014-12-03 00:00:00+11:00 (n=24)
Fold: 63
Training: No training in this fold
Validation: 2014-12-03 01:00:00+11:00 -- 2014-12-04 00:00:00+11:00 (n=24)
Fold: 64
Training: No training in this fold
Validation: 2014-12-04 01:00:00+11:00 -- 2014-12-05 00:00:00+11:00 (n=24)
Fold: 65
Training: No training in this fold
Validation: 2014-12-05 01:00:00+11:00 -- 2014-12-06 00:00:00+11:00 (n=24)
Fold: 66
Training: No training in this fold
Validation: 2014-12-06 01:00:00+11:00 -- 2014-12-07 00:00:00+11:00 (n=24)
Fold: 67
Training: No training in this fold
Validation: 2014-12-07 01:00:00+11:00 -- 2014-12-08 00:00:00+11:00 (n=24)
Fold: 68
Training: No training in this fold
Validation: 2014-12-08 01:00:00+11:00 -- 2014-12-09 00:00:00+11:00 (n=24)
Fold: 69
Training: No training in this fold
Validation: 2014-12-09 01:00:00+11:00 -- 2014-12-10 00:00:00+11:00 (n=24)
Fold: 70
Training: No training in this fold
Validation: 2014-12-10 01:00:00+11:00 -- 2014-12-11 00:00:00+11:00 (n=24)
Fold: 71
Training: No training in this fold
Validation: 2014-12-11 01:00:00+11:00 -- 2014-12-12 00:00:00+11:00 (n=24)
Fold: 72
Training: No training in this fold
Validation: 2014-12-12 01:00:00+11:00 -- 2014-12-13 00:00:00+11:00 (n=24)
Fold: 73
Training: No training in this fold
Validation: 2014-12-13 01:00:00+11:00 -- 2014-12-14 00:00:00+11:00 (n=24)
Fold: 74
Training: No training in this fold
Validation: 2014-12-14 01:00:00+11:00 -- 2014-12-15 00:00:00+11:00 (n=24)
Fold: 75
Training: No training in this fold
Validation: 2014-12-15 01:00:00+11:00 -- 2014-12-16 00:00:00+11:00 (n=24)
Fold: 76
Training: No training in this fold
Validation: 2014-12-16 01:00:00+11:00 -- 2014-12-17 00:00:00+11:00 (n=24)
Fold: 77
Training: No training in this fold
Validation: 2014-12-17 01:00:00+11:00 -- 2014-12-18 00:00:00+11:00 (n=24)
Fold: 78
Training: No training in this fold
Validation: 2014-12-18 01:00:00+11:00 -- 2014-12-19 00:00:00+11:00 (n=24)
Fold: 79
Training: No training in this fold
Validation: 2014-12-19 01:00:00+11:00 -- 2014-12-20 00:00:00+11:00 (n=24)
Fold: 80
Training: No training in this fold
Validation: 2014-12-20 01:00:00+11:00 -- 2014-12-21 00:00:00+11:00 (n=24)
Fold: 81
Training: No training in this fold
Validation: 2014-12-21 01:00:00+11:00 -- 2014-12-22 00:00:00+11:00 (n=24)
Fold: 82
Training: No training in this fold
Validation: 2014-12-22 01:00:00+11:00 -- 2014-12-23 00:00:00+11:00 (n=24)
Fold: 83
Training: No training in this fold
Validation: 2014-12-23 01:00:00+11:00 -- 2014-12-24 00:00:00+11:00 (n=24)
Fold: 84
Training: No training in this fold
Validation: 2014-12-24 01:00:00+11:00 -- 2014-12-25 00:00:00+11:00 (n=24)
Fold: 85
Training: No training in this fold
Validation: 2014-12-25 01:00:00+11:00 -- 2014-12-26 00:00:00+11:00 (n=24)
Fold: 86
Training: No training in this fold
Validation: 2014-12-26 01:00:00+11:00 -- 2014-12-27 00:00:00+11:00 (n=24)
Fold: 87
Training: No training in this fold
Validation: 2014-12-27 01:00:00+11:00 -- 2014-12-28 00:00:00+11:00 (n=24)
Fold: 88
Training: No training in this fold
Validation: 2014-12-28 01:00:00+11:00 -- 2014-12-29 00:00:00+11:00 (n=24)
Fold: 89
Training: No training in this fold
Validation: 2014-12-29 01:00:00+11:00 -- 2014-12-30 00:00:00+11:00 (n=24)
Fold: 90
Training: No training in this fold
Validation: 2014-12-30 01:00:00+11:00 -- 2014-12-31 00:00:00+11:00 (n=24)
Fold: 91
Training: No training in this fold
Validation: 2014-12-31 01:00:00+11:00 -- 2014-12-31 23:00:00+11:00 (n=23)
# Gráfico predicción vs valores reales
# ======================================================================================
fig = go.Figure()
fig.add_trace(
go.Scatter(x=datos_test.index, y=datos_test['Demand'], name='test', mode='lines')
)
fig.add_trace(
go.Scatter(
x=predicciones.index, y=predicciones['pred'], name='predicción', mode='lines'
)
)
fig.update_layout(
title='Predicción vs valores reales en test',
xaxis_title='Fecha',
yaxis_title='Demanda (MW)',
width=800,
height=400,
margin=dict(l=20, r=20, t=35, b=20),
legend=dict(orientation='h', yanchor='top', y=1.01, xanchor='left', x=0)
)
fig.show()
# Error de backtesting
# ==============================================================================
metrica_recursive_no_exog
| mean_absolute_error | |
|---|---|
| 0 | 278.152555 |
El modelo autorregresivo alcanza un MAE inferior al del modelo baseline, aunque la mejora es moderada. Al utilizar únicamente los valores pasados de la serie, el modelo no dispone de información sobre el día de la semana, sobre si un día es festivo ni sobre la temperatura, factores que tienen una gran influencia en la demanda eléctrica. Esto motiva el siguiente paso: incluir variables exógenas.
Variables exógenas
Hasta ahora, solo se han utilizado como predictores los valores pasados (lags) de la serie temporal. Sin embargo, es posible incluir otras variables como predictores. Estas variables se conocen como variables exógenas (features) y su uso puede mejorar la capacidad predictiva del modelo. Un punto muy importante que hay que tener en cuenta es que los valores de las variables exógenas deben conocerse en el momento de la predicción.
Ejemplos habituales de variables exógenas son aquellas obtenidas del calendario, como el día de la semana, el mes, el año o los días festivos. Las variables meteorológicas como la temperatura, la humedad y el viento también entran en esta categoría, al igual que las variables económicas como la inflación y los tipos de interés.
⚠️ Warning
Las variables exógenas deben conocerse en el momento de la predicción. Por ejemplo, si se utiliza la temperatura como variable exógena, el valor de la temperatura para la hora siguiente debe conocerse en el momento de la predicción. Si no se conoce el valor de la temperatura, la predicción no será posible.
Las variables meteorológicas deben utilizarse con precaución. Cuando el modelo se pone en producción, las condiciones meteorológicas futuras no se conocen, sino que son predicciones realizadas por los servicios meteorológicos. Al tratarse de predicciones, introducen errores en el modelo de forecasting. Como consecuencia, es probable que las predicciones del modelo empeoren. Una forma de anticiparse a este problema, y conocer (no evitar) el rendimiento esperado del modelo, es utilizar las previsiones meteorológicas disponibles en el momento en que se entrena el modelo, en lugar de las condiciones reales registradas.
A continuación, se crean variables exógenas basadas en información del calendario, las horas de salida y puesta del sol, la temperatura y los días festivos. Estas nuevas variables se añaden a los conjuntos de entrenamiento, validación y test, y se utilizan como predictores en el modelo autorregresivo.
💡 Tip
Algunos aspectos del calendario, como las horas o los días, son cíclicos. Por ejemplo, la hora del día va de 0 a 23 horas. Aunque se interpreta como una variable continua, las 23:00 solo distan una hora de las 00:00. Lo mismo ocurre con los meses del año, ya que diciembre solo dista un mes de enero. El uso de funciones trigonométricas como seno y coseno permite representar patrones cíclicos y evitar incoherencias en la representación de los datos. Este enfoque se conoce como codificación cíclica y puede mejorar significativamente la capacidad predictiva de los modelos.
Desde la versión 0.23.0, skforecast incluye el argumento calendar_features en la mayoría de los forecasters (y el transformador CalendarFeatures), lo que facilita la incorporación de variables cíclicas del calendario directamente en el pipeline de predicción sin necesidad de ningún preprocesamiento externo. Dicho esto, sigue siendo posible incluirlas como variables exógenas si así se prefiere.
# Variables basadas en el calendario
# ==============================================================================
calendar_transformer = CalendarFeatures(
features = ['month', 'week', 'day_of_week', 'hour'],
encoding = 'cyclical',
keep_original_columns = False,
)
variables_calendario = calendar_transformer.fit_transform(datos)
variables_calendario.head(2)
| month_sin | month_cos | week_sin | week_cos | day_of_week_sin | day_of_week_cos | hour_sin | hour_cos | |
|---|---|---|---|---|---|---|---|---|
| Time | ||||||||
| 2012-01-01 01:00:00+11:00 | 0.5 | 0.866025 | -0.118273 | 0.992981 | -0.781831 | 0.62349 | 0.258819 | 0.965926 |
| 2012-01-01 02:00:00+11:00 | 0.5 | 0.866025 | -0.118273 | 0.992981 | -0.781831 | 0.62349 | 0.500000 | 0.866025 |
# Variables basadas en la luz solar
# ==============================================================================
location = LocationInfo(
latitude = -37.8,
longitude = 144.95,
timezone = 'Australia/Melbourne'
)
# El amanecer y el atardecer solo dependen de la fecha, por lo que se calculan
# una vez por día
dates = pd.Series(datos.index.date, index=datos.index)
sun_by_date = {
date: sun(location.observer, date=date, tzinfo=location.timezone)
for date in dates.unique()
}
sunrise_hour = dates.map(lambda date: sun_by_date[date]['sunrise'])
sunset_hour = dates.map(lambda date: sun_by_date[date]['sunset'])
sunrise_hour = sunrise_hour.dt.round('h').dt.hour
sunset_hour = sunset_hour.dt.round('h').dt.hour
sunrise_hour_sin = np.sin(2 * np.pi * sunrise_hour / 24)
sunrise_hour_cos = np.cos(2 * np.pi * sunrise_hour / 24)
sunset_hour_sin = np.sin(2 * np.pi * sunset_hour / 24)
sunset_hour_cos = np.cos(2 * np.pi * sunset_hour / 24)
daylight_hours = sunset_hour - sunrise_hour
# Tanto el índice como las horas de amanecer y atardecer están en la hora
# local de Melbourne
is_daylight = np.where(
(datos.index.hour >= sunrise_hour) & (datos.index.hour < sunset_hour), 1, 0,
)
variables_solares = pd.DataFrame({
'sunrise_hour_sin': sunrise_hour_sin,
'sunrise_hour_cos': sunrise_hour_cos,
'sunset_hour_sin': sunset_hour_sin,
'sunset_hour_cos': sunset_hour_cos,
'daylight_hours': daylight_hours,
'is_daylight': is_daylight
})
variables_solares.head(2)
| sunrise_hour_sin | sunrise_hour_cos | sunset_hour_sin | sunset_hour_cos | daylight_hours | is_daylight | |
|---|---|---|---|---|---|---|
| Time | ||||||
| 2012-01-01 01:00:00+11:00 | 1.0 | 6.123234e-17 | -0.707107 | 0.707107 | 15 | 0 |
| 2012-01-01 02:00:00+11:00 | 1.0 | 6.123234e-17 | -0.707107 | 0.707107 | 15 | 0 |
# Variables basadas en festivos
# ==============================================================================
# Los festivos se conocen de antemano, por lo que utilizar el valor del día
# siguiente como predictor no es data leakage. El desplazamiento se expresa en
# steps (24 horas), por lo que se desvía una hora en los dos días al año en los
# que hay cambio de horario.
variables_festivos = datos[['Holiday']].astype(int)
variables_festivos['holiday_previous_day'] = variables_festivos['Holiday'].shift(24)
variables_festivos['holiday_next_day'] = variables_festivos['Holiday'].shift(-24)
variables_festivos.head(2)
| Holiday | holiday_previous_day | holiday_next_day | |
|---|---|---|---|
| Time | |||
| 2012-01-01 01:00:00+11:00 | 1 | NaN | 1.0 |
| 2012-01-01 02:00:00+11:00 | 1 | NaN | 1.0 |
# Variables basadas en temperatura
# ==============================================================================
wf_transformer = WindowFeatures(
variables = ['Temperature'],
window = ['1D', '7D'],
functions = ['mean', 'max', 'min'],
freq = 'h',
)
variables_temp = wf_transformer.fit_transform(datos[['Temperature']])
variables_temp.head(2)
| Temperature | Temperature_window_1D_mean | Temperature_window_1D_max | Temperature_window_1D_min | Temperature_window_7D_mean | Temperature_window_7D_max | Temperature_window_7D_min | |
|---|---|---|---|---|---|---|---|
| Time | |||||||
| 2012-01-01 01:00:00+11:00 | 21.225 | NaN | NaN | NaN | NaN | NaN | NaN |
| 2012-01-01 02:00:00+11:00 | 20.625 | 21.225 | 21.225 | 21.225 | 21.225 | 21.225 | 21.225 |
# Unión de variables exógenas
# ==============================================================================
assert all(variables_calendario.index == variables_solares.index)
assert all(variables_calendario.index == variables_temp.index)
assert all(variables_calendario.index == variables_festivos.index)
variables_exogenas = pd.concat([
variables_calendario,
variables_solares,
variables_temp,
variables_festivos
], axis=1)
# Debido a la creación de medias móviles, hay valores ausentes al principio
# de la serie. Y debido a holiday_next_day, hay valores ausentes al final.
variables_exogenas = variables_exogenas.iloc[7 * 24:, :]
variables_exogenas = variables_exogenas.iloc[:-24, :]
variables_exogenas.head(3)
| month_sin | month_cos | week_sin | week_cos | day_of_week_sin | day_of_week_cos | hour_sin | hour_cos | sunrise_hour_sin | sunrise_hour_cos | ... | Temperature | Temperature_window_1D_mean | Temperature_window_1D_max | Temperature_window_1D_min | Temperature_window_7D_mean | Temperature_window_7D_max | Temperature_window_7D_min | Holiday | holiday_previous_day | holiday_next_day | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Time | |||||||||||||||||||||
| 2012-01-08 01:00:00+11:00 | 0.5 | 0.866025 | 0.118273 | 0.992981 | -0.781831 | 0.62349 | 0.258819 | 0.965926 | 1.0 | 6.123234e-17 | ... | 22.20 | 22.801042 | 29.0 | 15.225 | 23.219940 | 39.525 | 14.35 | 0 | 0.0 | 0.0 |
| 2012-01-08 02:00:00+11:00 | 0.5 | 0.866025 | 0.118273 | 0.992981 | -0.781831 | 0.62349 | 0.500000 | 0.866025 | 1.0 | 6.123234e-17 | ... | 21.55 | 23.011458 | 29.0 | 15.225 | 23.225744 | 39.525 | 14.35 | 0 | 0.0 | 0.0 |
| 2012-01-08 03:00:00+11:00 | 0.5 | 0.866025 | 0.118273 | 0.992981 | -0.781831 | 0.62349 | 0.707107 | 0.707107 | 1.0 | 6.123234e-17 | ... | 21.25 | 23.200000 | 29.0 | 15.225 | 23.231250 | 39.525 | 14.35 | 0 | 0.0 | 0.0 |
3 rows × 24 columns
En muchos casos, las variables exógenas no actúan de forma aislada. Más bien, su efecto sobre la variable objetivo depende del valor de otras variables. Por ejemplo, el efecto de la hora del día sobre la demanda eléctrica depende del día de la semana: la rampa de la mañana es mucho más pronunciada en los días laborables que en los fines de semana. La interacción entre las variables exógenas puede captarse mediante nuevas variables que se obtienen multiplicando entre sí las variables existentes. Estas interacciones se obtienen fácilmente con la clase PolynomialFeatures de scikit-learn.
Se crean las interacciones entre todos los pares de variables exógenas pero, para limitar el número de predictores, en el siguiente paso solo se incluyen en el modelo las interacciones entre variables cíclicas (calendario y luz solar).
# Interacción entre variables exógenas
# ==============================================================================
transformer_poly = PolynomialFeatures(
degree = 2,
interaction_only = True,
include_bias = False
).set_output(transform='pandas')
poly_cols = [
'month_sin',
'month_cos',
'week_sin',
'week_cos',
'day_of_week_sin',
'day_of_week_cos',
'hour_sin',
'hour_cos',
'sunrise_hour_sin',
'sunrise_hour_cos',
'sunset_hour_sin',
'sunset_hour_cos',
'daylight_hours',
'is_daylight',
'holiday_previous_day',
'holiday_next_day',
'Temperature_window_1D_mean',
'Temperature_window_1D_min',
'Temperature_window_1D_max',
'Temperature_window_7D_mean',
'Temperature_window_7D_min',
'Temperature_window_7D_max',
'Temperature',
'Holiday'
]
variables_poly = transformer_poly.fit_transform(variables_exogenas[poly_cols])
variables_poly = variables_poly.drop(columns=poly_cols)
variables_poly.columns = [f'poly_{col}' for col in variables_poly.columns]
variables_poly.columns = variables_poly.columns.str.replace(' ', '__')
assert all(variables_poly.index == variables_exogenas.index)
variables_exogenas = pd.concat([variables_exogenas, variables_poly], axis=1)
variables_exogenas.head(3)
| month_sin | month_cos | week_sin | week_cos | day_of_week_sin | day_of_week_cos | hour_sin | hour_cos | sunrise_hour_sin | sunrise_hour_cos | ... | poly_Temperature_window_7D_mean__Temperature_window_7D_min | poly_Temperature_window_7D_mean__Temperature_window_7D_max | poly_Temperature_window_7D_mean__Temperature | poly_Temperature_window_7D_mean__Holiday | poly_Temperature_window_7D_min__Temperature_window_7D_max | poly_Temperature_window_7D_min__Temperature | poly_Temperature_window_7D_min__Holiday | poly_Temperature_window_7D_max__Temperature | poly_Temperature_window_7D_max__Holiday | poly_Temperature__Holiday | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Time | |||||||||||||||||||||
| 2012-01-08 01:00:00+11:00 | 0.5 | 0.866025 | 0.118273 | 0.992981 | -0.781831 | 0.62349 | 0.258819 | 0.965926 | 1.0 | 6.123234e-17 | ... | 333.206146 | 917.768147 | 515.482679 | 0.0 | 567.18375 | 318.5700 | 0.0 | 877.45500 | 0.0 | 0.0 |
| 2012-01-08 02:00:00+11:00 | 0.5 | 0.866025 | 0.118273 | 0.992981 | -0.781831 | 0.62349 | 0.500000 | 0.866025 | 1.0 | 6.123234e-17 | ... | 333.289427 | 917.997533 | 500.514784 | 0.0 | 567.18375 | 309.2425 | 0.0 | 851.76375 | 0.0 | 0.0 |
| 2012-01-08 03:00:00+11:00 | 0.5 | 0.866025 | 0.118273 | 0.992981 | -0.781831 | 0.62349 | 0.707107 | 0.707107 | 1.0 | 6.123234e-17 | ... | 333.368438 | 918.215156 | 493.664062 | 0.0 | 567.18375 | 304.9375 | 0.0 | 839.90625 | 0.0 | 0.0 |
3 rows × 300 columns
# Selección de variables exógenas incluidas en el modelo
# ==============================================================================
exog_features = []
# Se seleccionan las columnas que terminan en _sin o _cos (variables cíclicas
# y sus interacciones)
exog_features.extend(
variables_exogenas.filter(regex='_sin$|_cos$').columns.tolist()
)
# Se seleccionan las columnas que empiezan por Temperature_
exog_features.extend(
variables_exogenas.filter(regex='^Temperature_.*').columns.tolist()
)
# Se seleccionan las columnas que empiezan por holiday_
exog_features.extend(
variables_exogenas.filter(regex='^holiday_.*').columns.tolist()
)
# Se incluyen las variables originales
exog_features.extend(['Temperature', 'Holiday', 'daylight_hours', 'is_daylight'])
# Combinar la serie temporal y las variables exógenas en un único DataFrame
# ==============================================================================
datos = datos[['Demand']].merge(
variables_exogenas[exog_features],
left_index = True,
right_index = True,
how = 'inner' # Solo fechas con todas las variables
)
datos = datos.astype('float32')
# Separación datos train-val-test
datos_train = datos.loc[: fin_train, :].copy()
datos_val = datos.loc[fin_train:fin_validacion, :].copy()
datos_test = datos.loc[fin_validacion:, :].copy()
Se vuelve a evaluar el modelo mediante backtesting pero, esta vez, las variables exógenas también se incluyen como predictores. Dado que las últimas 24 horas de la serie se eliminaron al crear holiday_next_day, el conjunto de test es un día más corto que el utilizado con los modelos anteriores, por lo que la comparación con ellos no es estrictamente equivalente.
# Backtesting
# ==============================================================================
# Las particiones se crean de nuevo porque la longitud de `datos` ha cambiado
cv = TimeSeriesFold(
steps = 24,
initial_train_size = len(datos.loc[:fin_validacion]),
refit = False
)
metrica, predicciones = backtesting_forecaster(
forecaster = forecaster,
y = datos['Demand'],
exog = datos[exog_features],
cv = cv,
metric = 'mean_absolute_error'
)
metrica_recursive_exog = metrica
display(metrica_recursive_exog)
predicciones.head()
| mean_absolute_error | |
|---|---|
| 0 | 136.793083 |
| fold | pred | |
|---|---|---|
| 2014-10-01 00:00:00+10:00 | 0 | 4655.896488 |
| 2014-10-01 01:00:00+10:00 | 0 | 4268.012517 |
| 2014-10-01 02:00:00+10:00 | 0 | 3989.289917 |
| 2014-10-01 03:00:00+10:00 | 0 | 3717.910541 |
| 2014-10-01 04:00:00+10:00 | 0 | 3563.568931 |
La inclusión de variables exógenas como predictores mejora considerablemente la capacidad predictiva del modelo: el MAE se reduce aproximadamente a la mitad del obtenido utilizando únicamente los predictores autorregresivos.
Optimización de hiperparámetros (tuning)
El ForecasterRecursive entrenado utiliza los primeros 24 lags y un modelo LGBMRegressor con los hiperparámetros por defecto. Sin embargo, no hay ninguna razón por la que estos valores sean los más adecuados. Por ejemplo, el análisis exploratorio mostró una clara estacionalidad semanal que los primeros 24 lags no pueden capturar, por lo que los conjuntos de lags candidatos incluyen, además del último día o de los dos últimos días, los valores observados una semana antes en torno a la misma hora (lags 167, 168 y 169). Para encontrar la mejor configuración, se realiza una búsqueda bayesiana utilizando la función bayesian_search_forecaster. La búsqueda se lleva a cabo utilizando el mismo proceso de backtesting que antes, pero, en cada iteración, el modelo se entrena con una combinación diferente de hiperparámetros y lags. Es importante señalar que la búsqueda de hiperparámetros debe realizarse utilizando el conjunto de validación, de modo que los datos de test no se utilicen nunca.
💡 Tip
El proceso de búsqueda de hiperparámetros puede requerir una cantidad notable de tiempo, sobre todo si se utiliza una estrategia de validación basada en backtesting (TimeSeriesFold). Una alternativa más rápida consiste en utilizar una estrategia de validación basada en predicciones one-step-ahead (OneStepAheadFold). Esta estrategia es más rápida, pero puede no ser tan precisa como la validación basada en backtesting. Para obtener una descripción más detallada de los pros y los contras de cada estrategia, consúltese la sección backtesting vs one-step-ahead.
# Búsqueda bayesiana de hiperparámetros
# ==============================================================================
forecaster = ForecasterRecursive(
estimator = LGBMRegressor(random_state=15926, verbose=-1),
lags = 24, # Este valor se modifica durante la búsqueda
window_features = window_features
)
# Lags utilizados como predictores
lags_grid = [
# Día anterior
24,
# Dos días anteriores
48,
# Día anterior y misma hora (+-1) de la semana anterior
list(range(1, 25)) + [167, 168, 169],
# Horas más recientes y misma hora (+-1) de los dos días anteriores
[1, 2, 3, 23, 24, 25, 47, 48, 49],
# Igual que el anterior más la misma hora (+-1) de la semana anterior
[1, 2, 3, 23, 24, 25, 47, 48, 49, 167, 168, 169],
]
# Espacio de búsqueda de hiperparámetros
def search_space(trial):
params = {
'n_estimators' : trial.suggest_int('n_estimators', 300, 1000, step=100),
'max_depth' : trial.suggest_int('max_depth', 3, 10),
'learning_rate': trial.suggest_float('learning_rate', 0.01, 0.5),
'reg_alpha' : trial.suggest_float('reg_alpha', 0, 1),
'reg_lambda' : trial.suggest_float('reg_lambda', 0, 1),
'lags' : trial.suggest_categorical('lags', lags_grid)
}
return params
# Particiones de entrenamiento y validación
cv_search = TimeSeriesFold(
steps = 24,
initial_train_size = len(datos.loc[:fin_train]),
refit = False,
)
resultados_busqueda, frozen_trial = bayesian_search_forecaster(
forecaster = forecaster,
y = datos.loc[:fin_validacion, 'Demand'],
exog = datos.loc[:fin_validacion, exog_features],
cv = cv_search,
metric = 'mean_absolute_error',
search_space = search_space,
n_trials = 30, # Aumentar para una búsqueda más exhaustiva
return_best = True
)
# Resultados de la búsqueda
# ==============================================================================
best_params = resultados_busqueda.at[0, 'params']
best_params = best_params | {'random_state': 15926, 'verbose': -1}
best_lags = resultados_busqueda.at[0, 'lags']
resultados_busqueda.head(3)
| trial_number | lags | params | mean_absolute_error | n_estimators | max_depth | learning_rate | reg_alpha | reg_lambda | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 15 | [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14... | {'n_estimators': 900, 'max_depth': 4, 'learnin... | 148.108915 | 900.0 | 4.0 | 0.107898 | 0.413039 | 0.800044 |
| 1 | 27 | [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14... | {'n_estimators': 1000, 'max_depth': 3, 'learni... | 148.212575 | 1000.0 | 3.0 | 0.086918 | 0.503438 | 0.938266 |
| 2 | 18 | [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14... | {'n_estimators': 800, 'max_depth': 3, 'learnin... | 148.432061 | 800.0 | 3.0 | 0.117099 | 0.456209 | 0.775987 |
Al indicar return_best = True, el objeto forecaster se actualiza automáticamente con la mejor configuración encontrada y se reentrena con todos los datos utilizados en la búsqueda (conjuntos de entrenamiento y validación). El conjunto de test permanece sin utilizar. Este modelo final puede emplearse para obtener predicciones sobre nuevos datos.
# Mejor modelo
# ==============================================================================
forecaster
ForecasterRecursive
General Information
- Estimator: LGBMRegressor
- Lags: [ 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 167 168 169]
- Window features: ['roll_mean_72']
- Calendar features: None
- Window size: 169
- Series name: Demand
- Exogenous included: True
- Categorical features: auto
- Weight function included: False
- Differentiation order: None
- Drop NaN from series: False
- Creation date: 2026-09-22 09:18:35
- Last fit date: 2026-09-22 09:19:58
- Skforecast version: 0.25.0
- Python version: 3.13.14
- Forecaster id: None
Exogenous Variables
month_sin, month_cos, week_sin, week_cos, day_of_week_sin, day_of_week_cos, hour_sin, hour_cos, sunrise_hour_sin, sunrise_hour_cos, sunset_hour_sin, sunset_hour_cos, poly_month_sin__month_cos, poly_month_sin__week_sin, poly_month_sin__week_cos, poly_month_sin__day_of_week_sin, poly_month_sin__day_of_week_cos, poly_month_sin__hour_sin, poly_month_sin__hour_cos, poly_month_sin__sunrise_hour_sin, poly_month_sin__sunrise_hour_cos, poly_month_sin__sunset_hour_sin, poly_month_sin__sunset_hour_cos, poly_month_cos__week_sin, poly_month_cos__week_cos, …, poly_hour_sin__sunrise_hour_cos, poly_hour_sin__sunset_hour_sin, poly_hour_sin__sunset_hour_cos, poly_hour_cos__sunrise_hour_sin, poly_hour_cos__sunrise_hour_cos, poly_hour_cos__sunset_hour_sin, poly_hour_cos__sunset_hour_cos, poly_sunrise_hour_sin__sunrise_hour_cos, poly_sunrise_hour_sin__sunset_hour_sin, poly_sunrise_hour_sin__sunset_hour_cos, poly_sunrise_hour_cos__sunset_hour_sin, poly_sunrise_hour_cos__sunset_hour_cos, poly_sunset_hour_sin__sunset_hour_cos, Temperature_window_1D_mean, Temperature_window_1D_max, Temperature_window_1D_min, Temperature_window_7D_mean, Temperature_window_7D_max, Temperature_window_7D_min, holiday_previous_day, holiday_next_day, Temperature, Holiday, daylight_hours, is_daylight
Data Transformations
- Transformer for y: None
- Transformer for exog: None
Training Information
- Training range: [Timestamp('2012-01-08 01:00:00+1100', tz='Australia/Melbourne'), Timestamp('2014-09-30 23:00:00+1000', tz='Australia/Melbourne')]
- Training index type: DatetimeIndex
- Training index frequency: h
Estimator Parameters
-
{'boosting_type': 'gbdt', 'class_weight': None, 'colsample_bytree': 1.0, 'importance_type': 'split', 'learning_rate': 0.10789809062875491, 'max_depth': 4, 'min_child_samples': 20, 'min_child_weight': 0.001, 'min_split_gain': 0.0, 'n_estimators': 900, 'n_jobs': None, 'num_leaves': 31, 'objective': None, 'random_state': 15926, 'reg_alpha': 0.41303921667247323, 'reg_lambda': 0.8000438783265289, 'subsample': 1.0, 'subsample_for_bin': 200000, 'subsample_freq': 0, 'verbose': -1}
Fit Kwargs
-
{}
Una vez identificada la mejor combinación de hiperparámetros utilizando los datos de validación, se evalúa la capacidad predictiva del modelo cuando se aplica al conjunto de test.
# Backtesting del modelo final con los datos de test
# ==============================================================================
metrica, predicciones = backtesting_forecaster(
forecaster = forecaster,
y = datos['Demand'],
exog = datos[exog_features],
cv = cv,
metric = 'mean_absolute_error'
)
metrica_recursive_exog_tuned = metrica
display(metrica_recursive_exog_tuned)
predicciones.head()
| mean_absolute_error | |
|---|---|
| 0 | 124.963893 |
| fold | pred | |
|---|---|---|
| 2014-10-01 00:00:00+10:00 | 0 | 4708.947347 |
| 2014-10-01 01:00:00+10:00 | 0 | 4291.071720 |
| 2014-10-01 02:00:00+10:00 | 0 | 3947.055345 |
| 2014-10-01 03:00:00+10:00 | 0 | 3684.626319 |
| 2014-10-01 04:00:00+10:00 | 0 | 3537.783862 |
Tras la optimización de lags e hiperparámetros, el error de predicción en el conjunto de test se reduce todavía más, en torno a un 10%. La mejor configuración encontrada incluye los lags de la semana anterior, lo que es coherente con la estacionalidad semanal identificada en el análisis exploratorio.
Selección de predictores
La selección de predictores (feature selection) es el proceso de identificar un subconjunto de predictores relevantes para su uso en la creación del modelo. Es un paso importante en el proceso de machine learning, ya que puede ayudar a reducir el sobreajuste, mejorar la precisión del modelo y reducir el tiempo de entrenamiento. Dado que los estimadores subyacentes de skforecast siguen la API de scikit-learn, es posible utilizar los métodos de selección de predictores disponibles en scikit-learn con la función select_features. Dos de los métodos más populares son Recursive Feature Elimination y Sequential Feature Selection.
💡 Tip
La selección de predictores es una herramienta potente para mejorar el rendimiento de los modelos de machine learning. Sin embargo, es computacionalmente costosa y puede requerir mucho tiempo. Dado que el objetivo es encontrar el mejor subconjunto de predictores, no el mejor modelo, no es necesario utilizar todos los datos disponibles ni un modelo muy complejo. En su lugar, se recomienda utilizar un pequeño subconjunto de los datos y un modelo sencillo. Una vez identificados los mejores predictores, el modelo puede entrenarse utilizando todo el conjunto de datos y una configuración más compleja.
# Crear forecaster
# ==============================================================================
estimator = LGBMRegressor(
n_estimators = 100,
max_depth = 4,
random_state = 15926,
verbose = -1
)
forecaster = ForecasterRecursive(
estimator = estimator,
lags = best_lags,
window_features = window_features
)
# Eliminación recursiva de predictores con validación cruzada
# ==============================================================================
warnings.filterwarnings('ignore', message='X does not have valid feature names.*')
selector = RFECV(
estimator = estimator,
step = 1,
cv = 3,
)
lags_select, window_features_select, exog_select, _ = select_features(
forecaster = forecaster,
selector = selector,
y = datos_train['Demand'],
exog = datos_train[exog_features],
select_only = None,
force_inclusion = None,
subsample = 0.5, # Muestreo para acelerar el cálculo
random_state = 123,
verbose = True,
)
Recursive feature elimination (RFECV)
-------------------------------------
Total number of records available: 17206
Total number of records used for feature selection: 8603
Number of features available: 118
Lags (n=27)
Window features (n=1)
Exog (n=90)
Calendar (n=0)
Number of features selected: 33
Lags (n=15) : [1, 2, 3, 4, 5, 8, 10, 11, 17, 21, 23, 24, 167, 168, 169]
Window features (n=1) : ['roll_mean_72']
Exog (n=17) : ['day_of_week_sin', 'hour_sin', 'hour_cos', 'poly_week_sin__hour_cos', 'poly_week_cos__hour_sin', 'poly_week_cos__hour_cos', 'poly_day_of_week_sin__hour_sin', 'poly_day_of_week_cos__hour_sin', 'poly_hour_sin__hour_cos', 'poly_hour_sin__sunset_hour_sin', 'poly_hour_sin__sunset_hour_cos', 'poly_hour_cos__sunrise_hour_sin', 'poly_hour_cos__sunset_hour_sin', 'poly_hour_cos__sunset_hour_cos', 'Temperature_window_1D_mean', 'Temperature', 'Holiday']
Calendar (n=0) : []
# Conservar solo las window features seleccionadas
# ==============================================================================
# `select_features` devuelve los nombres de las window features seleccionadas.
# El objeto RollingFeatures se crea de nuevo solo con los estadísticos
# seleccionados. Si no se selecciona ninguno, se devuelve None (forecaster sin
# window features).
def filter_rolling_features(window_features, selected_names):
keep = [
i for i, name in enumerate(window_features.features_names)
if name in selected_names
]
if not keep:
return None
return RollingFeatures(
stats = [window_features.stats[i] for i in keep],
window_sizes = [window_features.window_sizes[i] for i in keep],
min_periods = [window_features.min_periods[i] for i in keep],
features_names = [window_features.features_names[i] for i in keep],
fillna = window_features.fillna,
kwargs_stats = window_features.kwargs_stats,
)
window_features_select = filter_rolling_features(
window_features, window_features_select
)
print(f'Window features seleccionadas: {window_features_select}')
Window features seleccionadas: RollingFeatures(
stats = ['mean'],
window_sizes = [72],
Max window size = 72,
min_periods = [72],
features_names = ['roll_mean_72'],
fillna = None
kwargs_stats = {'ewm': {'alpha': 0.3}},
)
El RFECV de scikit-learn empieza entrenando un modelo con todos los predictores disponibles y calculando la importancia de cada uno a partir de atributos como coef_ o feature_importances_. A continuación, en cada ronda, se eliminan los predictores menos importantes y se realiza una validación cruzada para calcular el rendimiento del modelo con los predictores restantes. Este proceso continúa hasta que la eliminación de más predictores deja de mejorar, o empieza a empeorar, el rendimiento del modelo (según la métrica elegida), o hasta que se alcanza el valor de min_features_to_select.
El resultado final es un subconjunto de predictores que idealmente equilibra la simplicidad del modelo y su capacidad predictiva, determinada por el proceso de validación cruzada.
Nótese que la selección se realiza utilizando únicamente el conjunto de entrenamiento. De este modo, ni los datos de validación ni los de test influyen en qué predictores se eligen, lo que sería una forma de data leakage.
El forecaster se entrena y reevalúa utilizando el mejor subconjunto de predictores. Los lags y las variables exógenas seleccionados pueden pasarse directamente al forecaster, mientras que el objeto RollingFeatures debe crearse de nuevo solo con los estadísticos seleccionados.
El cuarto valor devuelto por select_features (ignorado en este ejemplo) contiene las variables de calendario seleccionadas cuando es el propio forecaster quien las crea mediante su argumento calendar_features. En este documento, las variables de calendario se incluyen como variables exógenas, por lo que las seleccionadas ya forman parte de exog_select.
# Crear un forecaster con los predictores seleccionados
# ==============================================================================
forecaster = ForecasterRecursive(
estimator = LGBMRegressor(**best_params),
lags = lags_select,
window_features = window_features_select
)
# Backtesting con los predictores seleccionados y los datos de test
# ==============================================================================
metrica, predicciones = backtesting_forecaster(
forecaster = forecaster,
y = datos['Demand'],
exog = datos[exog_select],
cv = cv,
metric = 'mean_absolute_error'
)
metrica_recursive_exog_selection = metrica
display(metrica_recursive_exog_selection)
predicciones.head()
| mean_absolute_error | |
|---|---|
| 0 | 127.651776 |
| fold | pred | |
|---|---|---|
| 2014-10-01 00:00:00+10:00 | 0 | 4685.101362 |
| 2014-10-01 01:00:00+10:00 | 0 | 4303.202742 |
| 2014-10-01 02:00:00+10:00 | 0 | 3958.553482 |
| 2014-10-01 03:00:00+10:00 | 0 | 3687.715103 |
| 2014-10-01 04:00:00+10:00 | 0 | 3552.627351 |
El número de predictores se ha reducido a menos de un tercio de los disponibles inicialmente sin comprometer el rendimiento del modelo: el MAE en el conjunto de test es muy similar al obtenido con todos los predictores. Esto simplifica el modelo y acelera el entrenamiento. Además, reduce el riesgo de sobreajuste, ya que es menos probable que el modelo aprenda ruido de predictores irrelevantes.
Conviene tener en cuenta que RFECV evalúa los predictores según su capacidad para predecir el siguiente valor de la serie (one-step-ahead), utilizando un modelo sencillo y una submuestra de los datos, mientras que el forecaster se utiliza para predecir 24 steps de forma recursiva. Por este motivo, el resultado de una selección de predictores debe validarse siempre con el mismo proceso de backtesting utilizado para evaluar el modelo, tal como se ha hecho aquí.
Forecasting probabilístico: intervalos de predicción
Un intervalo de predicción define el intervalo dentro del cual es de esperar que se encuentre el verdadero valor de la variable respuesta con una determinada probabilidad. Skforecast implementa varios métodos para el forecasting probabilístico:
El siguiente código muestra cómo generar intervalos de predicción con el modelo autorregresivo. En primer lugar, se utiliza el método predict_interval() para estimar los intervalos de cada step predicho. Después, se utiliza la función backtesting_forecaster() para generar los intervalos de predicción de todo el conjunto de test. El argumento interval se utiliza para especificar la probabilidad de cobertura deseada de los intervalos. En este caso, interval se establece en [0.05, 0.95], lo que significa que los intervalos están delimitados por los cuantiles 0.05 y 0.95, lo que da como resultado una cobertura teórica del 90%. Los intervalos se estiman mediante predicción conformal (method='conformal').
# Crear y entrenar el forecaster
# ==============================================================================
forecaster = ForecasterRecursive(
estimator = LGBMRegressor(**best_params),
lags = lags_select,
window_features = window_features_select,
binner_kwargs = {'n_bins': 5}
)
forecaster.fit(
y = datos.loc[:fin_train, 'Demand'],
exog = datos.loc[:fin_train, exog_select],
store_in_sample_residuals = True
)
# Predecir intervalos
# ==============================================================================
# Dado que el modelo se ha entrenado con variables exógenas, estas deben
# proporcionarse también en la predicción.
predicciones = forecaster.predict_interval(
exog = datos.loc[fin_train:, exog_select],
steps = 24,
interval = [0.05, 0.95],
method = 'conformal',
)
predicciones.head()
| pred | lower_bound | upper_bound | |
|---|---|---|---|
| 2014-01-01 00:00:00+11:00 | 3681.692968 | 3638.045084 | 3725.340851 |
| 2014-01-01 01:00:00+11:00 | 3983.376442 | 3926.454053 | 4040.298831 |
| 2014-01-01 02:00:00+11:00 | 3589.144237 | 3545.496354 | 3632.792121 |
| 2014-01-01 03:00:00+11:00 | 3398.423476 | 3354.775593 | 3442.071360 |
| 2014-01-01 04:00:00+11:00 | 3143.147336 | 3099.499452 | 3186.795220 |
Por defecto, los intervalos se calculan utilizando los residuos in-sample (residuos del conjunto de entrenamiento). Sin embargo, esto puede dar lugar a intervalos demasiado estrechos (demasiado optimistas). Para evitarlo, se utiliza el método set_out_sample_residuals() para almacenar residuos out-sample calculados mediante backtesting con un conjunto de validación. Este es el motivo por el que el forecaster se ha entrenado utilizando únicamente el conjunto de entrenamiento: el modelo no ha visto los datos de validación, por lo que sus residuos son una estimación realista del error esperado con datos nuevos.
Si, además de los valores reales, se pasan los valores predichos a set_out_sample_residuals(), los residuos se agrupan en intervalos (bins) según la magnitud de la predicción a la que están asociados. De este modo, la amplitud del intervalo de predicción puede condicionarse al rango de valores de las predicciones (se calcula un factor de corrección diferente para cada bin). Esto puede ayudar a mejorar la cobertura de los intervalos estimados a la vez que se mantienen lo más estrechos posible.
# Backtesting sobre los datos de validación para obtener los residuos out-sample
# ==============================================================================
cv = TimeSeriesFold(
steps = 24,
initial_train_size = len(datos.loc[:fin_train]),
refit = False,
)
metrica_val, predicciones_val = backtesting_forecaster(
forecaster = forecaster,
y = datos.loc[:fin_validacion, 'Demand'],
exog = datos.loc[:fin_validacion, exog_select],
cv = cv,
metric = 'mean_absolute_error'
)
metrica_val
| mean_absolute_error | |
|---|---|
| 0 | 149.897846 |
# Distribución de los residuos out-sample
# ==============================================================================
residuos = datos.loc[predicciones_val.index, 'Demand'] - predicciones_val['pred']
print(pd.Series(np.where(residuos < 0, 'negative', 'positive')).value_counts())
_ = plot_residuals(residuals=residuos, figsize=(7, 4))
negative 3845 positive 2708 Name: count, dtype: int64

Los residuos out-sample no están perfectamente equilibrados: hay claramente más residuos negativos que positivos, lo que significa que, en el periodo de validación, el modelo sobreestima la demanda con más frecuencia de la que la subestima. Dado que los intervalos conformales son simétricos en torno a la predicción, un sesgo en los residuos puede hacer que la cobertura empírica se desvíe de la cobertura nominal.
# Almacenar los residuos out-sample en el forecaster
# ==============================================================================
forecaster.set_out_sample_residuals(
y_true = datos.loc[predicciones_val.index, 'Demand'],
y_pred = predicciones_val['pred']
)
A continuación, se ejecuta el proceso de backtesting para estimar los intervalos de predicción en el conjunto de test. Se indica el argumento use_in_sample_residuals en False para que se utilicen los residuos out-sample almacenados previamente, y use_binned_residuals en True para que la amplitud de los intervalos se condicione al rango de los valores predichos.
# Backtesting con intervalos de predicción en test utilizando residuos out-sample
# ==============================================================================
cv = TimeSeriesFold(
steps = 24,
initial_train_size = len(datos.loc[:fin_validacion]),
refit = False,
)
metrica, predicciones = backtesting_forecaster(
forecaster = forecaster,
y = datos['Demand'],
exog = datos[exog_select],
cv = cv,
metric = 'mean_absolute_error',
interval = [0.05, 0.95],
interval_method = 'conformal',
use_in_sample_residuals = False, # Se utilizan los residuos out-sample
use_binned_residuals = True, # Intervalos condicionados a los valores predichos
)
predicciones.head(5)
| fold | pred | lower_bound | upper_bound | |
|---|---|---|---|---|
| 2014-10-01 00:00:00+10:00 | 0 | 4685.101362 | 4399.429700 | 4970.773024 |
| 2014-10-01 01:00:00+10:00 | 0 | 4303.202742 | 4060.318335 | 4546.087148 |
| 2014-10-01 02:00:00+10:00 | 0 | 3958.553482 | 3715.669075 | 4201.437888 |
| 2014-10-01 03:00:00+10:00 | 0 | 3687.715103 | 3528.710759 | 3846.719447 |
| 2014-10-01 04:00:00+10:00 | 0 | 3552.627351 | 3393.623007 | 3711.631695 |
# Gráfico intervalos de predicción vs valores reales
# ==============================================================================
fig = go.Figure([
go.Scatter(
name='Predicción', x=predicciones.index, y=predicciones['pred'], mode='lines',
),
go.Scatter(
name='Valor real', x=datos_test.index, y=datos_test['Demand'], mode='lines',
),
go.Scatter(
name='Upper Bound', x=predicciones.index, y=predicciones['upper_bound'],
mode='lines', marker=dict(color='#444'), line=dict(width=0), showlegend=False
),
go.Scatter(
name='Lower Bound', x=predicciones.index, y=predicciones['lower_bound'],
marker=dict(color='#444'), line=dict(width=0), mode='lines',
fillcolor='rgba(68, 68, 68, 0.3)', fill='tonexty', showlegend=False
)
])
fig.update_layout(
title='Predicción con intervalos vs valores reales en test',
xaxis_title='Fecha',
yaxis_title='Demanda (MW)',
width=800,
height=400,
margin=dict(l=20, r=20, t=35, b=20),
hovermode='x',
legend=dict(orientation='h', yanchor='top', y=1.1, xanchor='left', x=0.001)
)
fig.show()
# Cobertura del intervalo predicho (en los datos de test)
# ==============================================================================
cobertura = calculate_coverage(
y_true = datos.loc[predicciones.index, 'Demand'],
lower_bound = predicciones['lower_bound'],
upper_bound = predicciones['upper_bound']
)
area = (predicciones['upper_bound'] - predicciones['lower_bound']).sum()
print(f'Área total del intervalo: {round(area, 2)}')
print(f'Cobertura del intervalo predicho: {round(100 * cobertura, 2)} %')
Área total del intervalo: 1196003.7 Cobertura del intervalo predicho: 91.39 %
La cobertura observada de los intervalos es próxima a la cobertura teórica esperada (90%). La predicción conformal solo alcanza la cobertura nominal si los residuos utilizados en la calibración son representativos de los errores que el modelo cometerá en el futuro, por lo que es una buena práctica monitorizar la cobertura empírica a lo largo del tiempo.
✏️ Note
Para una explicación más detallada de las funcionalidades de forecasting probabilístico disponibles en skforecast, consultar: Forecasting probabilístico con machine learning.
Explicabilidad e interpretabilidad del modelo
Debido a la naturaleza compleja de muchos de los actuales modelos de machine learning, como los métodos de ensemble, a menudo funcionan como cajas negras, lo que dificulta entender por qué han hecho una predicción u otra. Las técnicas de explicabilidad pretenden desmitificar estos modelos, proporcionando información sobre su funcionamiento interno y ayudando a generar confianza, mejorar la transparencia y cumplir los requisitos normativos en diversos ámbitos. Mejorar la explicabilidad de los modelos no solo ayuda a comprender su comportamiento, sino también a identificar sesgos, mejorar su rendimiento y permitir a las partes interesadas tomar decisiones mejor informadas.
Skforecast es compatible con algunos de los métodos de explicabilidad más populares: importancia de los predictores propia del modelo, valores SHAP y gráficos de dependencia parcial.
# Crear y entrenar el forecaster
# ==============================================================================
forecaster = ForecasterRecursive(
estimator = LGBMRegressor(**best_params),
lags = lags_select,
window_features = window_features_select
)
forecaster.fit(
y = datos.loc[:fin_validacion, 'Demand'],
exog = datos.loc[:fin_validacion, exog_select]
)
Importancia de los predictores propia del modelo
Algunos modelos, como los basados en árboles o los modelos lineales, cuantifican de forma inherente la importancia de sus predictores, sin necesidad de técnicas adicionales.
# Importancia de los predictores en el modelo
# ==============================================================================
feature_importances = forecaster.get_feature_importances()
feature_importances.head(10)
| feature | importance | |
|---|---|---|
| 0 | lag_1 | 1408 |
| 31 | Temperature | 706 |
| 14 | lag_169 | 664 |
| 13 | lag_168 | 630 |
| 1 | lag_2 | 558 |
| 30 | Temperature_window_1D_mean | 522 |
| 11 | lag_24 | 511 |
| 12 | lag_167 | 426 |
| 19 | poly_week_sin__hour_cos | 411 |
| 20 | poly_week_cos__hour_sin | 365 |
⚠️ Warning
El método get_feature_importances() solo devuelve valores si el estimador del forecaster tiene el atributo coef_ o feature_importances_, que es la convención seguida por los estimadores compatibles con scikit-learn. En el caso de LGBMRegressor, la importancia por defecto es el número de veces que un predictor se utiliza para dividir los datos (importance_type='split').
Valores SHAP
Los valores SHAP (SHapley Additive exPlanations) son un método muy utilizado para explicar los modelos de machine learning, ya que ayudan a comprender cómo influyen las variables y los valores en las predicciones de forma visual y cuantitativa.
Se puede obtener un análisis SHAP a partir de modelos skforecast con solo dos elementos:
El estimador interno del forecaster.
Las matrices de entrenamiento creadas a partir de la serie temporal y de las variables exógenas, utilizadas para ajustar el forecaster. Pueden obtenerse con el método
create_train_X_y().
Aprovechando estos dos componentes, los usuarios pueden crear explicaciones interpretables para sus modelos de skforecast. Estas explicaciones pueden utilizarse para verificar la fiabilidad del modelo, identificar los factores más significativos que contribuyen a las predicciones y comprender mejor la relación subyacente entre las variables de entrada y la variable objetivo.
# Matrices de entrenamiento utilizadas para ajustar el estimador interno
# ==============================================================================
X_train, y_train = forecaster.create_train_X_y(
y = datos.loc[:fin_validacion, 'Demand'],
exog = datos.loc[:fin_validacion, exog_select]
)
display(X_train.head(3))
display(y_train.head(3))
| lag_1 | lag_2 | lag_3 | lag_4 | lag_5 | lag_8 | lag_10 | lag_11 | lag_17 | lag_21 | ... | poly_day_of_week_cos__hour_sin | poly_hour_sin__hour_cos | poly_hour_sin__sunset_hour_sin | poly_hour_sin__sunset_hour_cos | poly_hour_cos__sunrise_hour_sin | poly_hour_cos__sunset_hour_sin | poly_hour_cos__sunset_hour_cos | Temperature_window_1D_mean | Temperature | Holiday | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Time | |||||||||||||||||||||
| 2012-01-15 02:00:00+11:00 | 4034.345215 | 3917.997803 | 4066.915039 | 4243.320801 | 4216.548340 | 4349.076660 | 4220.792969 | 4222.214844 | 4085.964600 | 3346.562500 | ... | 0.311745 | 0.433013 | -0.353553 | 0.353553 | 0.866025 | -0.612372 | 0.612372 | 16.826042 | 15.925 | 0.0 |
| 2012-01-15 03:00:00+11:00 | 3713.539551 | 4034.345215 | 3917.997803 | 4066.915039 | 4243.320801 | 4343.717285 | 4296.699219 | 4220.792969 | 4308.874512 | 3369.772705 | ... | 0.440874 | 0.500000 | -0.500000 | 0.500000 | 0.707107 | -0.500000 | 0.500000 | 16.827084 | 15.600 | 0.0 |
| 2012-01-15 04:00:00+11:00 | 3755.494873 | 3713.539551 | 4034.345215 | 3917.997803 | 4066.915039 | 4258.691406 | 4349.076660 | 4296.699219 | 4395.372070 | 3539.111328 | ... | 0.539958 | 0.433013 | -0.612372 | 0.612372 | 0.500000 | -0.353553 | 0.353553 | 16.821875 | 15.275 | 0.0 |
3 rows × 33 columns
Time 2012-01-15 02:00:00+11:00 3713.539551 2012-01-15 03:00:00+11:00 3755.494873 2012-01-15 04:00:00+11:00 3466.537598 Freq: h, Name: y, dtype: float32
# Crear SHAP explainer (para modelos basados en árboles)
# ==============================================================================
shap.initjs()
explainer = shap.TreeExplainer(forecaster.estimator)
# Se selecciona una muestra del 50% de los datos para acelerar el cálculo
X_train_sample = X_train.sample(frac=0.5, random_state=785412)
shap_values = explainer.shap_values(X_train_sample)

✏️ Note
La librería SHAP cuenta con varios explainers, cada uno diseñado para un tipo de modelo diferente. El shap.TreeExplainer se utiliza para modelos basados en árboles, como el LGBMRegressor utilizado en este ejemplo. Para más información, consultar la documentación de SHAP.
# SHAP summary plot (top 10)
# ==============================================================================
shap.summary_plot(shap_values, X_train_sample, max_display=10, show=False)
fig, ax = plt.gcf(), plt.gca()
ax.set_title('SHAP Summary plot')
ax.tick_params(labelsize=8)
fig.set_size_inches(6, 4.5)

Los valores SHAP no solo permiten interpretar el comportamiento general del modelo, sino que también son una herramienta potente para analizar predicciones individuales. Esto resulta especialmente útil cuando se quiere entender cómo se ha generado una predicción específica y qué variables han contribuido a ella.
Para llevar a cabo este análisis, es necesario acceder a los valores de los predictores (lags, window features y variables exógenas utilizados por el modelo) en el momento de la predicción. Esto puede lograrse utilizando el método create_predict_X() o bien activando el argumento return_predictors=True en la función backtesting_forecaster().
Supóngase que se quiere entender la predicción obtenida durante el backtesting para la fecha 2014-12-16 12:00:00.
# Backtesting indicando que se devuelvan los predictores
# ==============================================================================
cv = TimeSeriesFold(
steps = 24,
initial_train_size = len(datos.loc[:fin_validacion]),
refit = False,
)
_, predicciones = backtesting_forecaster(
forecaster = forecaster,
y = datos['Demand'],
exog = datos[exog_select],
cv = cv,
metric = 'mean_absolute_error',
return_predictors = True,
)
Al indicar return_predictors=True, se obtiene un DataFrame con el valor predicho ('pred'), la partición en la que se encuentra ('fold') y el valor de los lags y de las variables exógenas utilizados para realizar cada predicción.
# Predicciones y predictores
# ==============================================================================
predicciones.head(3)
| fold | pred | lag_1 | lag_2 | lag_3 | lag_4 | lag_5 | lag_8 | lag_10 | lag_11 | ... | poly_day_of_week_cos__hour_sin | poly_hour_sin__hour_cos | poly_hour_sin__sunset_hour_sin | poly_hour_sin__sunset_hour_cos | poly_hour_cos__sunrise_hour_sin | poly_hour_cos__sunset_hour_sin | poly_hour_cos__sunset_hour_cos | Temperature_window_1D_mean | Temperature | Holiday | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 2014-10-01 00:00:00+10:00 | 0 | 4685.101362 | 4500.020508 | 4787.905273 | 5105.510742 | 5334.274414 | 5396.043457 | 4973.561035 | 4851.727051 | 4824.649902 | ... | -0.000000 | 0.000000 | -0.000000 | -0.000000e+00 | 1.000000 | -1.000000 | -1.836970e-16 | 15.931250 | 9.35 | 0.0 |
| 2014-10-01 01:00:00+10:00 | 0 | 4303.202742 | 4685.101362 | 4500.020508 | 4787.905273 | 5105.510742 | 5334.274414 | 5064.426270 | 4975.687012 | 4851.727051 | ... | -0.057593 | 0.250000 | -0.258819 | -4.754429e-17 | 0.965926 | -0.965926 | -1.774377e-16 | 15.604167 | 8.65 | 0.0 |
| 2014-10-01 02:00:00+10:00 | 0 | 3958.553482 | 4303.202742 | 4685.101362 | 4500.020508 | 4787.905273 | 5105.510742 | 5219.281250 | 4973.561035 | 4975.687012 | ... | -0.111260 | 0.433013 | -0.500000 | -9.184851e-17 | 0.866025 | -0.866025 | -1.590863e-16 | 15.250000 | 8.55 | 0.0 |
3 rows × 35 columns
# Waterfall para una predicción concreta generada durante el backtesting
# ==============================================================================
predictors = predicciones.drop(columns=['fold', 'pred'])
# Asegurar que los tipos son los mismos que en las matrices de entrenamiento
predictors = predictors.astype(datos[exog_select].dtypes)
iloc_predicted_date = predicciones.index.get_loc('2014-12-16 12:00:00')
shap_values_single = explainer(predictors)
shap.plots.waterfall(shap_values_single[iloc_predicted_date], show=False)
fig = plt.gcf()
fig.set_size_inches(8, 3.5)
fig.axes[0].tick_params(labelsize=8)
plt.show()

# Force plot para una predicción concreta generada durante el backtesting
# ==============================================================================
shap.force_plot(
base_value = shap_values_single.base_values[iloc_predicted_date],
shap_values = shap_values_single.values[iloc_predicted_date],
features = predictors.iloc[iloc_predicted_date, :],
)
Have you run `initjs()` in this notebook? If this notebook was from another user you must also trust this notebook (File -> Trust notebook). If you are viewing this notebook on github the Javascript has been stripped for security. If you are using JupyterLab this error is because a JupyterLab extension has not yet been written.
Forecasting multi-step directo
El modelo ForecasterRecursive sigue una estrategia recursiva en la que cada nueva predicción se basa en la anterior. Otra estrategia para predecir múltiples valores futuros consiste en entrenar un modelo diferente para cada step a predecir. Esto se conoce como direct multi-step forecasting y está implementado en la clase ForecasterDirect. Aunque es más costosa computacionalmente que la estrategia recursiva, debido a la necesidad de entrenar múltiples modelos, puede dar mejores resultados.
# Forecaster con el método direct
# ==============================================================================
forecaster = ForecasterDirect(
estimator = LGBMRegressor(**best_params),
steps = 24,
lags = lags_select,
window_features = window_features_select
)
# Backtesting
# ==============================================================================
metrica, predicciones = backtesting_forecaster(
forecaster = forecaster,
y = datos['Demand'],
exog = datos[exog_select],
cv = cv,
metric = 'mean_absolute_error'
)
metrica_direct_exog_selection = metrica
display(metrica_direct_exog_selection)
predicciones.head()
| mean_absolute_error | |
|---|---|
| 0 | 115.015906 |
| fold | pred | |
|---|---|---|
| 2014-10-01 00:00:00+10:00 | 0 | 4689.263993 |
| 2014-10-01 01:00:00+10:00 | 0 | 4274.539900 |
| 2014-10-01 02:00:00+10:00 | 0 | 3928.846442 |
| 2014-10-01 03:00:00+10:00 | 0 | 3630.445743 |
| 2014-10-01 04:00:00+10:00 | 0 | 3497.781927 |
El modelo direct multi-step supera al modelo recursivo entrenado con los mismos predictores, reduciendo el error absoluto medio en torno a un 10%. Dado que cada step tiene su propio modelo, la estrategia directa se ve menos afectada por la acumulación de errores a lo largo del horizonte de predicción. Sin embargo, es importante tener en cuenta su mayor coste computacional a la hora de evaluar si merece la pena aplicarlo.
Predicción diaria anticipada
Hasta ahora, se ha evaluado el modelo asumiendo que las predicciones del día siguiente se generan exactamente a las 23:59 de cada día. En la práctica, esto no resulta muy útil, ya que no deja tiempo suficiente para planificar y gestionar las operaciones de las primeras horas del día siguiente.
Supóngase ahora que, para poder tener suficiente margen de acción, a las 11:00 horas de cada día se tienen que generar las predicciones del día siguiente. Es decir, a las 11:00 del día $D$ se tienen que predecir las horas [12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23] de ese mismo día, y las horas [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23] del día $D+1$. Esto implica que se tienen que predecir un total de 36 horas a futuro, aunque solo se almacenen las 24 últimas.
Este tipo de evaluación puede realizarse fácilmente combinando la función backtesting_forecaster() con el argumento gap de TimeSeriesFold. Además, el argumento allow_incomplete_fold de TimeSeriesFold controla si se conserva la última partición cuando no tiene el número de steps requerido (en este ejemplo se utiliza su valor por defecto, True). El proceso adaptado a este escenario se ejecuta diariamente y consta de los siguientes pasos:
A las 11:00 del primer día del conjunto de test, se predicen las 36 horas siguientes (las 12 horas que quedan del día más las 24 horas del día siguiente).
Se almacenan solo las predicciones del día siguiente, es decir, a partir de la posición 12.
Se añaden los datos de test hasta las 11:00 del día siguiente.
Se repite el proceso.
De esta forma, a las 11:00 de cada día, el modelo tiene acceso a los valores reales de demanda registrados hasta ese momento.
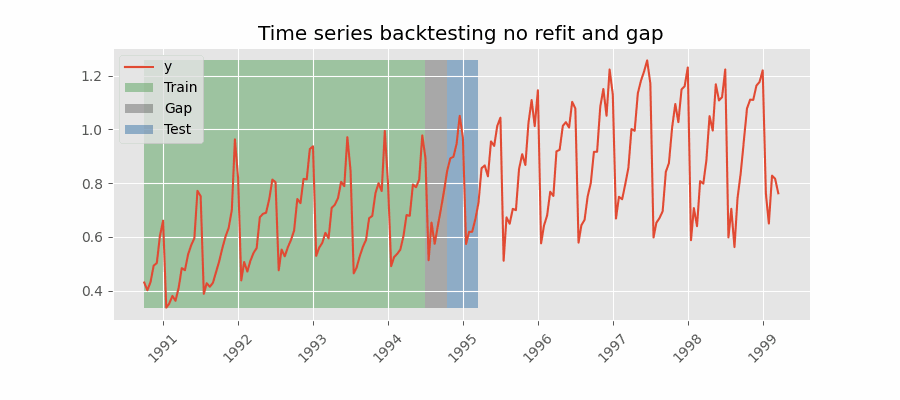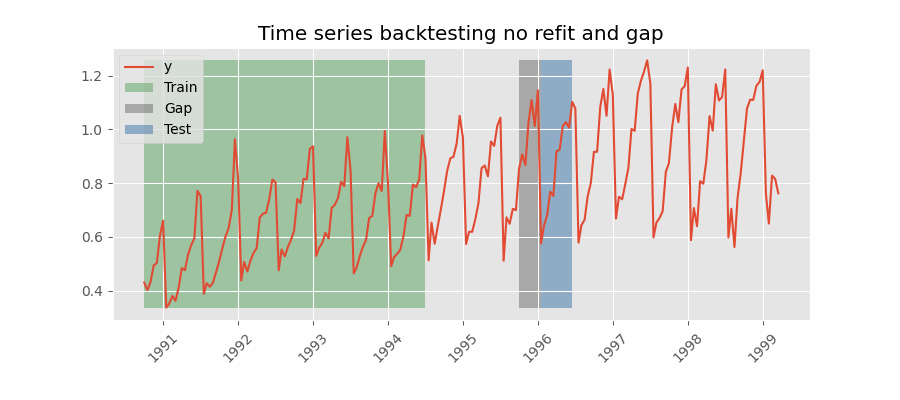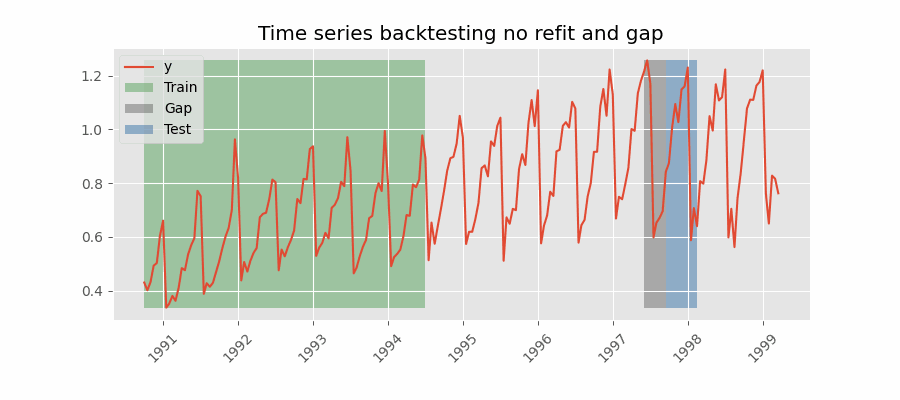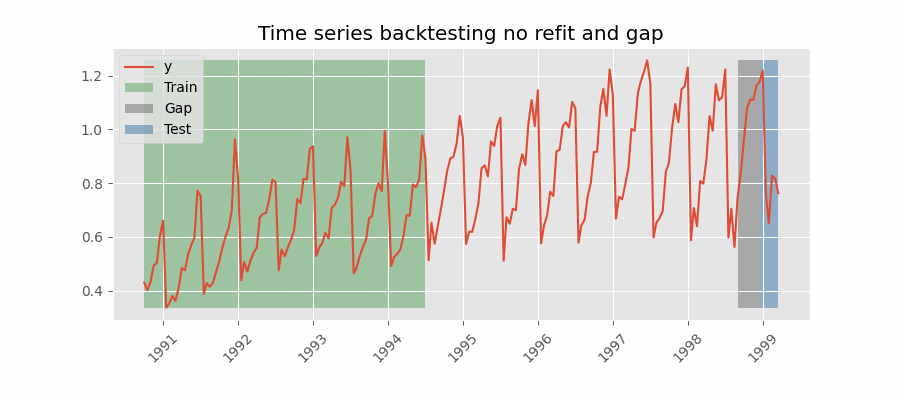
⚠️ Warning
Se deben tener en cuenta las siguientes consideraciones:
- Los datos de entrenamiento deben terminar donde empieza el gap. En este caso, el
initial_train_sizedebe ampliarse en 12 posiciones para que los datos de entrenamiento terminen el 2014-10-01 11:00:00. El primer step predicho es el 2014-10-01 12:00:00 (descartado por formar parte del gap) y la primera predicción almacenada es la del 2014-10-02 00:00:00. - En este ejemplo, aunque solo se almacenan las últimas 24 predicciones (steps) para la evaluación del modelo, el número total de steps predichos en cada partición es de 36 (steps + gap).
# Final de initial_train_size + 12 posiciones
# ==============================================================================
datos.iloc[:len(datos.loc[:fin_validacion]) + 12].tail(2)
| Demand | month_sin | month_cos | week_sin | week_cos | day_of_week_sin | day_of_week_cos | hour_sin | hour_cos | sunrise_hour_sin | ... | Temperature_window_1D_min | Temperature_window_7D_mean | Temperature_window_7D_max | Temperature_window_7D_min | holiday_previous_day | holiday_next_day | Temperature | Holiday | daylight_hours | is_daylight | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Time | |||||||||||||||||||||
| 2014-10-01 10:00:00+10:00 | 5069.862793 | -0.866025 | 0.5 | -0.999561 | 0.029633 | 0.974928 | -0.222521 | 0.500000 | -0.866025 | 1.0 | ... | 7.3 | 16.525892 | 27.35 | 7.3 | 0.0 | 0.0 | 13.35 | 0.0 | 12.0 | 1.0 |
| 2014-10-01 11:00:00+10:00 | 4984.418457 | -0.866025 | 0.5 | -0.999561 | 0.029633 | 0.974928 | -0.222521 | 0.258819 | -0.965926 | 1.0 | ... | 7.3 | 16.480953 | 27.35 | 7.3 | 0.0 | 0.0 | 14.20 | 0.0 | 12.0 | 1.0 |
2 rows × 91 columns
# Forecaster
# ==============================================================================
forecaster = ForecasterRecursive(
estimator = LGBMRegressor(**best_params),
lags = lags_select,
window_features = window_features_select
)
# Backtesting con gap
# ==============================================================================
cv = TimeSeriesFold(
steps = 24,
initial_train_size = len(datos.loc[:fin_validacion]) + 12,
refit = False,
gap = 12,
)
metrica, predicciones = backtesting_forecaster(
forecaster = forecaster,
y = datos['Demand'],
exog = datos[exog_select],
cv = cv,
metric = 'mean_absolute_error'
)
display(metrica)
predicciones.head(5)
| mean_absolute_error | |
|---|---|
| 0 | 137.442676 |
| fold | pred | |
|---|---|---|
| 2014-10-02 00:00:00+10:00 | 0 | 4648.312730 |
| 2014-10-02 01:00:00+10:00 | 0 | 4262.076003 |
| 2014-10-02 02:00:00+10:00 | 0 | 3915.741748 |
| 2014-10-02 03:00:00+10:00 | 0 | 3639.160143 |
| 2014-10-02 04:00:00+10:00 | 0 | 3464.580335 |
Como era de esperar, el error aumenta al pasar el horizonte de predicción de 24 a 36 horas.
Conclusiones
El uso de modelos gradient boosting ha demostrado ser una potente herramienta para predecir la demanda de energía. Una de las principales ventajas de estos modelos es que pueden incorporar fácilmente variables exógenas, lo que puede mejorar significativamente su capacidad predictiva. Además, el uso de técnicas de explicabilidad puede ayudar a comprender visual y cuantitativamente cómo afectan las variables y sus valores a las predicciones. Todas estas cuestiones se abordan fácilmente con la librería skforecast.
La evolución del error absoluto medio (MAE) en el conjunto de test, mostrada en la tabla siguiente, resume la contribución de cada paso:
Un forecaster recursivo que utiliza únicamente los últimos 24 lags y una media móvil mejora el modelo baseline (misma hora del día anterior), aunque solo de forma moderada.
Añadir variables exógenas (calendario, luz solar, temperatura y festivos) es el paso con mayor impacto: el error se reduce aproximadamente a la mitad.
La optimización de lags e hiperparámetros aporta una reducción adicional en torno a un 10%. La mejor configuración incluye los lags de la semana anterior.
La selección de predictores conserva menos de un tercio de los predictores con un error muy similar, lo que da lugar a un modelo más sencillo y rápido.
Con los mismos predictores, la estrategia directa consigue el menor error, a cambio de un mayor coste computacional.
Cuando la predicción debe emitirse con 12 horas de antelación, el error aumenta, como cabe esperar al ampliar el horizonte de predicción.
# Resultados
# ======================================================================================
forecaster_type = [
'ForecasterEquivalentDate (Baseline)', 'ForecasterRecursive',
'ForecasterRecursive', 'ForecasterRecursive', 'ForecasterRecursive',
'ForecasterDirect'
]
exog_included = [
'False', 'False', 'True', 'True', 'True (Feature Selection)',
'True (Feature Selection)'
]
tuned = ['False', 'False', 'False', 'True', 'True', 'True']
metrics = pd.concat(
[
metrica_baseline, metrica_recursive_no_exog, metrica_recursive_exog,
metrica_recursive_exog_tuned, metrica_recursive_exog_selection,
metrica_direct_exog_selection
],
axis=0,
)
metrics.insert(0, 'Forecaster', forecaster_type)
metrics.insert(1, 'Exogenous Variables', exog_included)
metrics.insert(2, 'Tuned Hyperparameters', tuned)
metrics = (
metrics.reset_index(drop=True).round(2).sort_values(by='mean_absolute_error')
)
metrics
| Forecaster | Exogenous Variables | Tuned Hyperparameters | mean_absolute_error | |
|---|---|---|---|---|
| 5 | ForecasterDirect | True (Feature Selection) | True | 115.02 |
| 3 | ForecasterRecursive | True | True | 124.96 |
| 4 | ForecasterRecursive | True (Feature Selection) | True | 127.65 |
| 2 | ForecasterRecursive | True | False | 136.79 |
| 1 | ForecasterRecursive | False | False | 278.15 |
| 0 | ForecasterEquivalentDate (Baseline) | False | False | 318.69 |
Información de sesión
import session_info
session_info.show(html=False)
----- astral 3.2 feature_engine 1.9.4 lightgbm 4.7.0 matplotlib 3.10.9 numpy 2.4.6 optuna 4.9.0 pandas 2.3.3 plotly 6.9.0 session_info v1.0.1 shap 0.52.0 skforecast 0.25.0 sklearn 1.7.2 statsmodels 0.14.6 ----- IPython 9.15.0 jupyter_client 8.9.1 jupyter_core 5.9.1 ----- Python 3.13.14 | packaged by conda-forge | (main, Jun 12 2026, 09:44:26) [MSC v.1944 64 bit (AMD64)] Windows-11-10.0.26200-SP0 ----- Session information updated at 2026-09-22 09:21
Instrucciones para citar
Cómo citar este documento
Si utilizas este documento o alguna parte de él, te agradecemos que lo cites. ¡Muchas gracias!
Predicción (forecasting) de la demanda energética con machine learning por Joaquín Amat Rodrigo y Javier Escobar Ortiz, disponible con licencia Attribution-NonCommercial-ShareAlike 4.0 International (CC BY-NC-SA 4.0 DEED) en https://www.cienciadedatos.net/documentos/py29-forecasting-demanda-energia-electrica-python.html
¿Cómo citar skforecast?
Si utilizas skforecast, te agradeceríamos mucho que lo cites. ¡Muchas gracias!
Zenodo:
Amat Rodrigo, Joaquin, & Escobar Ortiz, Javier. (2026). skforecast (v0.25.0). Zenodo. https://doi.org/10.5281/zenodo.8382788
APA:
Amat Rodrigo, J., & Escobar Ortiz, J. (2026). skforecast (Version 0.25.0) [Computer software]. https://doi.org/10.5281/zenodo.8382788
BibTeX:
@software{skforecast, author = {Amat Rodrigo, Joaquin and Escobar Ortiz, Javier}, title = {skforecast}, version = {0.25.0}, month = {09}, year = {2026}, license = {BSD-3-Clause}, url = {https://skforecast.org/}, doi = {10.5281/zenodo.8382788} }
¿Te ha gustado el artículo? Tu ayuda es importante
Tu contribución me ayudará a seguir generando contenido divulgativo gratuito. ¡Muchísimas gracias! 😊



Este documento creado por Joaquín Amat Rodrigo y Javier Escobar Ortiz tiene licencia Attribution-NonCommercial-ShareAlike 4.0 International.
Se permite:
-
Compartir: copiar y redistribuir el material en cualquier medio o formato.
-
Adaptar: remezclar, transformar y crear a partir del material.
Bajo los siguientes términos:
-
Atribución: Debes otorgar el crédito adecuado, proporcionar un enlace a la licencia e indicar si se realizaron cambios. Puedes hacerlo de cualquier manera razonable, pero no de una forma que sugiera que el licenciante te respalda o respalda tu uso.
-
No-Comercial: No puedes utilizar el material para fines comerciales.
-
Compartir-Igual: Si remezclas, transformas o creas a partir del material, debes distribuir tus contribuciones bajo la misma licencia que el original.